# kubernetes中的informer机制
# 引言
使用k8s中list与watch来获取资源
listwatch demo
package main

import (
	"context"
	"flag"
	"fmt"
	"os"
	"path/filepath"

	coreV1 "k8s.io/api/core/v1"

	metav1 "k8s.io/apimachinery/pkg/apis/meta/v1"

	"k8s.io/client-go/kubernetes"
	"k8s.io/client-go/rest"
	"k8s.io/client-go/tools/clientcmd"
)

func getClientSet() *kubernetes.Clientset {
	var err error
	var config *rest.Config
	var kubeConfig *string
	if home := homeDir(); home != "" {
		kubeConfig = flag.String("kubeconfig", filepath.Join(home, ".kube", "config"), "(optional) absolute path to the kubeconfig file")
	} else {
		kubeConfig = flag.String("kubeconfig", "", "absolute path to the kubeconfig file")
	}
	flag.Parse()
	// 使用 ServiceAccount 创建集群配置(InCluster模式)
	if config, err = rest.InClusterConfig(); err != nil {
		// 使用 KubeConfig 文件创建集群配置
		if config, err = clientcmd.BuildConfigFromFlags("", *kubeConfig); err != nil {
			panic(err.Error())
		}
	}
	// 创建 clientSet
	clientSet, err := kubernetes.NewForConfig(config)
	if err != nil {
		panic(err.Error())
	}
	return clientSet
}

func homeDir() string {
	if h := os.Getenv("HOME"); h != "" {
		return h
	}
	return os.Getenv("USERPROFILE") // windows
}

func Must(err error) {
	if err != nil {
		panic(err.Error())
	}
}

func main() {
	clientSet := getClientSet()
	ctx := context.Background()
	// kubectl run --image=nginx nginx-app --port=80
	podList, err := clientSet.CoreV1().Pods("default").List(ctx, metav1.ListOptions{})
	Must(err)
	if len(podList.Items) == 0 {
		fmt.Println("当前命名空间下POD资源为空")
	} else {
		for _, pod := range podList.Items {
			fmt.Printf("List获取到POD: %s\n", pod.Name)
		}
	}
	fmt.Println("开始watch POD 变化...")
	w, err := clientSet.CoreV1().Pods("default").Watch(ctx, metav1.ListOptions{})
	Must(err)
	defer w.Stop()

	for {
		select {
		case event := <-w.ResultChan():
			pod, ok := event.Object.(*coreV1.Pod)
			if !ok {
				return
			}
			fmt.Printf("Watch 到 %s 变化,EventType: %s\n", pod.Name, event.Type)
			fmt.Println("------------")
		}
	}
}

// 注意: 每次resourceVersion 都会增加
//新增 ADD
//修改 Modify  调度完成 绑定nodeName,更新status字段
//修改 Modify  status 增加更多字段,主要是修改status的message信息,例如 "containers with unready status: [nginx-app]"
//修改 Modify  从cni网络插件中获取到POD的ip地址并填充到status中,status的message置为空,修改pod运行状态为Running
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
分享内容
- list&watch使用 informer介绍
- Reflector、DeltaFIFO、Indexer、ShardInformer、Workqueue各组件作用与源码走读
- 使用informer实现一个自定义控制器
# 一、informer介绍
做过业务开发的同学应该知道mysql与redis的关系,当我们访问量很大时,会有大量的请求发送到mysql,此时我们可以引入redis作为我们的缓存,将业务的热点数据存放到redis中,查询时直接从缓存中查询,大大减轻了对mysql的压力,
对于k8s来讲也是一样的,在k8s中各个控制器或组件需要获取到各种资源对象,并且如果资源对象如果发生变化,控制器希望能进行自己逻辑处理,比如deployment控制器需要不断去维护pod数量与副本数的一致,如果每次都需要调用API获取资源或者使用watch启动一个长链接,会对APIserver造成很大的压力并且网络调用速度会相对慢一些,
此时我们需要一个类似redis一样的缓存机制来缓存我们k8s中的资源对象,并且如果资源对象发生变化,通过回调函数通知到控制器执行逻辑,Informers 的内存缓存就是来解决这个问题的
使用informer与不使用 对比 (by 白总)
https://github.com/chenghongxi/kubernetes-learning/tree/master/informer
所有演示代码仓库: https://github.com/noovertime7/dailytest.git
informer各组件代码位置: https://github.com/kubernetes/kubernetes/blob/master/staging/src/k8s.io/client-go/tools/cache/delta_fifo.go
貔貅小分队主页 https://space.bilibili.com/3493104248162809
多集群管理平台gopixiu https://github.com/caoyingjunz/gopixiu
k8s极速小白部署工具 https://github.com/caoyingjunz/kubez-ansible.git
# 1.1 informer介绍

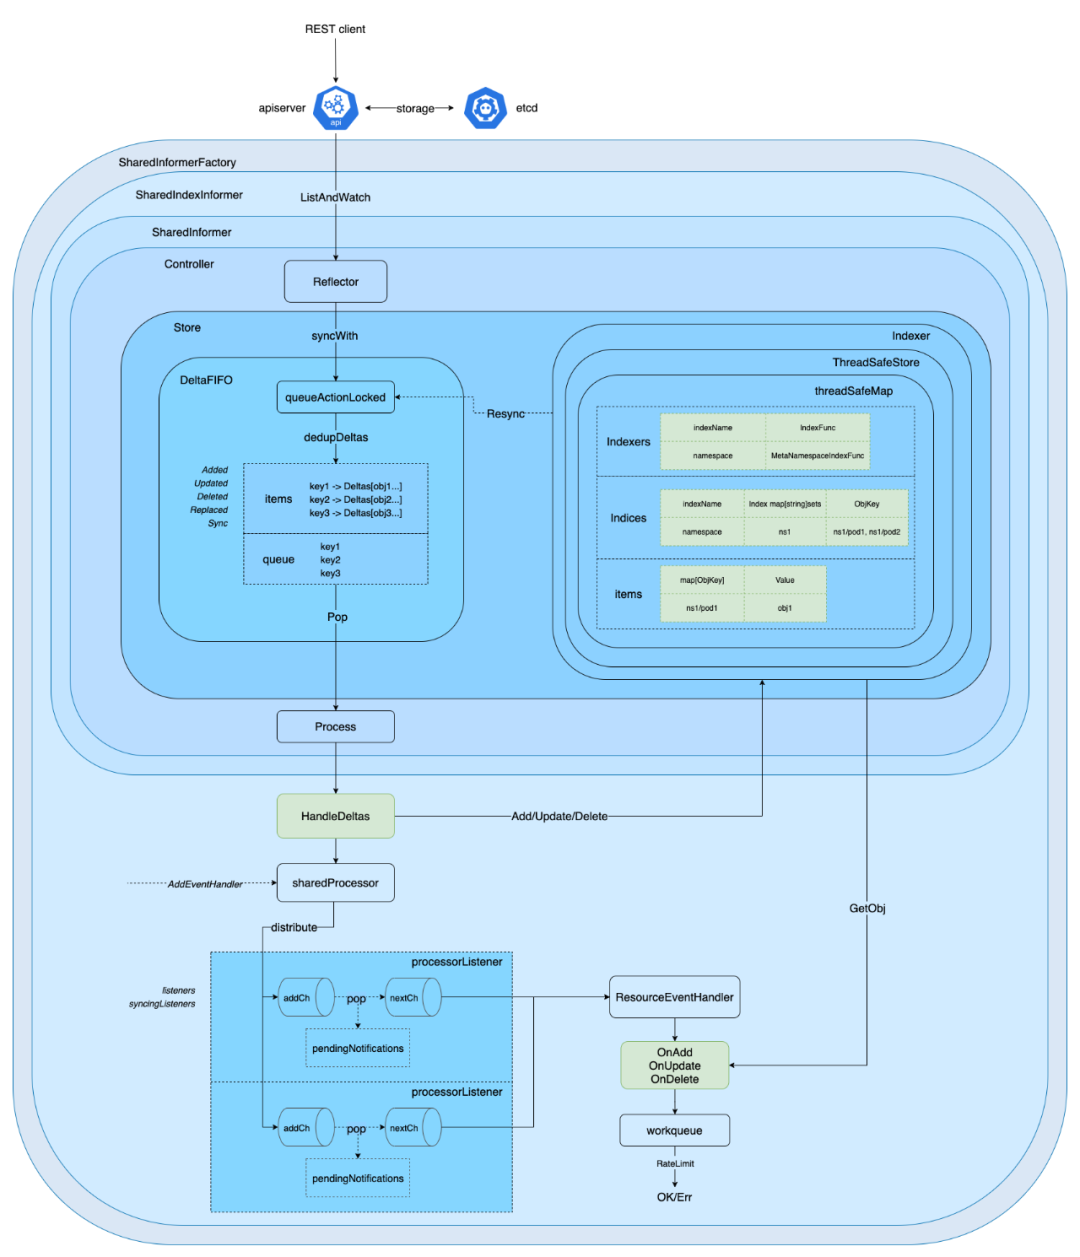
如上图展示了 Informer 的基本处理流程:
- 以 events 事件 (opens new window)的方式从 APIServer 获取数据
- 提供一个类似客户端的 Lister 接口,从内存缓存(Informer)中 get 和 list 对象
- 为添加、删除、更新注册事件处理程序
# 1.2 informer架构说明


- 首先初始化 Informer,Reflector 通过 List 接口获取所有的 Pod 对象
- Reflector 拿到所有 Pod 后,将全部 Pod 放到 Store(本地缓存)中
- 如果有人调用 Lister 的 List/Get 方法获取 Pod,那么 Lister 直接从 Store 中去拿数据
- Informer 初始化完成后,Reflector 开始 Watch Pod 相关的事件
- 此时如果我们删除 Pod1,那么 Reflector 会监听到这个事件,然后将这个事件发送到 DeltaFIFO 中
- DeltaFIFO 首先先将这个事件存储在一个队列中,然后去操作 Store 中的数据,删除其中的 Pod1
- DeltaFIFO 然后 Pop 这个事件到事件处理器(资源事件处理器)中进行处理
- LocalStore 会周期性地把所有的 Pod 信息重新放回 DeltaFIFO 中去
Reflector(反射器) 生产者
Reflector 用于监控(Watch)指定的 Kubernetes 资源,当监控的资源发生变化时,触发相应的变更事件,例如 Add 事件、Update 事件、Delete 事件,并将其资源对象存放到本地缓存 DeltaFIFO 中。
DeltaFIFO : 一个存储Delta类型数据的FIFO
DeltaFIFO 是一个生产者-消费者的队列,生产者是 Reflector,消费者是 Pop 函数,FIFO 是一个先进先出的队列,而 Delta 是一个资源对象存储,它可以保存资源对象的操作类型,例如 Add 操作类型、Update 操作类型、Delete 操作类型、Sync 操作类型等。
Indexer : 一个实现了index功能的store
Indexer 是 client-go 用来存储资源对象并自带索引功能的本地存储,Informer(sharedIndexInformer) 从 DeltaFIFO 中将消费出来的资源对象存储至 Indexer。Indexer 与 Etcd 集群中的数据保持完全一致。这样我们就可以很方便地从本地存储中读取相应的资源对象数据,而无须每次从远程 APIServer 中读取,以减轻服务器的压力。
这里理论知识太多,直接去查看源码显得有一定困难,我们可以用一个实际的示例来进行说明,比如现在我们删除一个 Pod,一个 Informers 的执行流程是怎样的:
源码级详细理解
# 1.3 informer demo
package main

import (
	"flag"
	"fmt"
	"log"
	"os"
	"path/filepath"

    v1 "k8s.io/api/core/v1"
	"k8s.io/apimachinery/pkg/labels"
	"k8s.io/client-go/informers"
	"k8s.io/client-go/kubernetes"
	"k8s.io/client-go/rest"
	"k8s.io/client-go/tools/cache"
	"k8s.io/client-go/tools/clientcmd"
)

func getClientSet() *kubernetes.Clientset {
	var err error
	var config *rest.Config
	var kubeConfig *string
	if home := homeDir(); home != "" {
		kubeConfig = flag.String("kubeconfig", filepath.Join(home, ".kube", "config"), "(optional) absolute path to the kubeconfig file")
	} else {
		kubeConfig = flag.String("kubeconfig", "", "absolute path to the kubeconfig file")
	}
	flag.Parse()
	// 使用 ServiceAccount 创建集群配置(InCluster模式)
	if config, err = rest.InClusterConfig(); err != nil {
		// 使用 KubeConfig 文件创建集群配置
		if config, err = clientcmd.BuildConfigFromFlags("", *kubeConfig); err != nil {
			panic(err.Error())
		}
	}
	// 创建 clientSet
	clientSet, err := kubernetes.NewForConfig(config)
	if err != nil {
		panic(err.Error())
	}
	return clientSet
}

func homeDir() string {
	if h := os.Getenv("HOME"); h != "" {
		return h
	}
	return os.Getenv("USERPROFILE") // windows
}

func main() {
	clientSet := getClientSet()
	factory := informers.NewSharedInformerFactoryWithOptions(clientSet, 0)
	podInformer := factory.Core().V1().Pods()
	// 向factory注册podInformer
	informer := podInformer.Informer()
	indexer := podInformer.Lister()
	informer.AddEventHandler(cache.ResourceEventHandlerFuncs{
		AddFunc: func(obj interface{}) {
			fmt.Println("add", obj.(*v1.Pod).Name)
		},
		UpdateFunc: func(oldObj, newObj interface{}) {
			fmt.Println("update", oldObj.(*v1.Pod).Name)
		},
		DeleteFunc: func(obj interface{}) {
			fmt.Println("delete", obj.(*v1.Pod).Name)
		},
	})
	// 可以添加多个EventHandler
	informer.AddEventHandler(cache.ResourceEventHandlerFuncs{
		AddFunc: func(obj interface{}) {
			fmt.Println("add2", obj.(*v1.Pod).Name)
		},
	})
	stopCh := make(chan struct{})
	// 启动factory
	factory.Start(stopCh)
	defer close(stopCh)
	//等待所有的informer同步完成
	factory.WaitForCacheSync(stopCh)

	pods, err := indexer.Pods(v1.NamespaceAll).List(labels.Everything())
	if err != nil {
		log.Fatalln(err)
	}

	for index, pod := range pods {
		fmt.Println(index, "->", pod.Name)
	}
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
# 二、各组件源码分析
# 2.1 Refactor
# 2.1.1 Reflector 源码分析
前面我们说了 Informer 通过对 APIServer 的资源对象执行 List 和 Watch 操作,把获取到的数据存储在本地的缓存中,其中实现这个的核心功能就是 Reflector,我们可以称其为反射器,就是将 Etcd 里面的数据反射到本地存储(DeltaFIFO)中。Reflector 首先通过 List 操作获取所有的资源对象数据,保存到本地存储,然后通过 Watch 操作监控资源的变化,触发相应的事件处理,比如前面示例中的 Add 事件、Update 事件、Delete 事件。
Reflector 结构体的定义位于 staging/src/k8s.io/client-go/tools/cache/reflector.go 下面:
// Reflector(反射器) 监听指定的资源,将所有的变化都反射到给定的存储中去
type Reflector struct {
	// name 标识这个反射器的名称,默认为 文件:行数(比如reflector.go:125)
  // 默认名字通过 k8s.io/apimachinery/pkg/util/naming/from_stack.go 下面的 GetNameFromCallsite 函数生成
	name string

  // 期望放到 Store 中的类型名称,如果提供,则是 expectedGVK 的字符串形式
  // 否则就是 expectedType 的字符串,它仅仅用于显示,不用于解析或者比较。
	expectedTypeName string
	// An example object of the type we expect to place in the store.
	// Only the type needs to be right, except that when that is
	// `unstructured.Unstructured` the object's `"apiVersion"` and
	// `"kind"` must also be right.
  // 我们放到 Store 中的对象类型
	expectedType reflect.Type
	// 如果是非结构化的,我们期望放在 Sotre 中的对象的 GVK
	expectedGVK *schema.GroupVersionKind
	// 与 watch 源同步的目标 Store
	store Store
	// 用来执行 lists 和 watches 操作的 listerWatcher 接口(最重要的)
	listerWatcher ListerWatcher

	// backoff manages backoff of ListWatch
	backoffManager wait.BackoffManager

	resyncPeriod time.Duration
	// ShouldResync 会周期性的被调用,当返回 true 的时候,就会调用 Store 的 Resync 操作
	ShouldResync func() bool
	// clock allows tests to manipulate time
	clock clock.Clock
	// paginatedResult defines whether pagination should be forced for list calls.
	// It is set based on the result of the initial list call.
	paginatedResult bool
	// Kubernetes 资源在 APIServer 中都是有版本的,对象的任何修改(添加、删除、更新)都会造成资源版本更新,lastSyncResourceVersion 就是指的这个版本
	lastSyncResourceVersion string
	// 如果之前的 list 或 watch 带有 lastSyncResourceVersion 的请求中是一个 HTTP 410(Gone)的失败请求,则 isLastSyncResourceVersionGone 为 true
	isLastSyncResourceVersionGone bool
	// lastSyncResourceVersionMutex 用于保证对 lastSyncResourceVersion 的读/写访问。
	lastSyncResourceVersionMutex sync.RWMutex
	// WatchListPageSize is the requested chunk size of initial and resync watch lists.
	// If unset, for consistent reads (RV="") or reads that opt-into arbitrarily old data
	// (RV="0") it will default to pager.PageSize, for the rest (RV != "" && RV != "0")
	// it will turn off pagination to allow serving them from watch cache.
	// NOTE: It should be used carefully as paginated lists are always served directly from
	// etcd, which is significantly less efficient and may lead to serious performance and
	// scalability problems.
	WatchListPageSize int64
}

// NewReflector 创建一个新的反射器对象,将使给定的 Store 保持与服务器中指定的资源对象的内容同步。
// 反射器只把具有 expectedType 类型的对象放到 Store 中,除非 expectedType 是 nil。
// 如果 resyncPeriod 是非0,那么反射器会周期性地检查 ShouldResync 函数来决定是否调用 Store 的 Resync 操作
// `ShouldResync==nil` 意味着总是要执行 Resync 操作。
// 这使得你可以使用反射器周期性地处理所有的全量和增量的对象。
func NewReflector(lw ListerWatcher, expectedType interface{}, store Store, resyncPeriod time.Duration) *Reflector {
  // 默认的反射器名称为 file:line
	return NewNamedReflector(naming.GetNameFromCallsite(internalPackages...), lw, expectedType, store, resyncPeriod)
}

// NewNamedReflector 与 NewReflector 一样,只是指定了一个 name 用于日志记录
func NewNamedReflector(name string, lw ListerWatcher, expectedType interface{}, store Store, resyncPeriod time.Duration) *Reflector {
	realClock := &clock.RealClock{}
	r := &Reflector{
		name:          name,
		listerWatcher: lw,
		store:         store,
		backoffManager: wait.NewExponentialBackoffManager(800*time.Millisecond, 30*time.Second, 2*time.Minute, 2.0, 1.0, realClock),
		resyncPeriod:   resyncPeriod,
		clock:          realClock,
	}
	r.setExpectedType(expectedType)
	return r
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
从源码中我们可以看出来通过 NewReflector 实例化反射器的时候,必须传入一个ListerWatcher 接口对象,这个也是反射器最核心的功能,该接口拥有 List 和 Watch 方法,用于获取和监控资源对象
// k8s.io/client-go/tools/cache/listwatch.go

// Lister 是知道如何执行初始化List列表的对象
type Lister interface {
	// List 应该返回一个列表类型的对象;
  // Items 字段将被解析,ResourceVersion 字段将被用于正确启动 watch 的地方
	List(options metav1.ListOptions) (runtime.Object, error)
}

// Watcher 是知道如何执行 watch 操作的任何对象
type Watcher interface {
	// Watch 在指定的版本开始执行 watch 操作
	Watch(options metav1.ListOptions) (watch.Interface, error)
}

// ListerWatcher 是任何知道如何对一个资源执行初始化List列表和启动Watch监控操作的对象
type ListerWatcher interface {
	Lister
	Watcher
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
而 Reflector 对象通过 Run 函数来启动监控并处理监控事件的:
// k8s.io/client-go/tools/cache/reflector.go

// Run 函数反复使用反射器的 ListAndWatch 函数来获取所有对象和后续的 deltas。
// 当 stopCh 被关闭的时候,Run函数才会退出。
func (r *Reflector) Run(stopCh <-chan struct{}) {
	klog.V(2).Infof("Starting reflector %s (%s) from %s", r.expectedTypeName, r.resyncPeriod, r.name)
	wait.BackoffUntil(func() {
		if err := r.ListAndWatch(stopCh); err != nil {
			utilruntime.HandleError(err)
		}
	}, r.backoffManager, true, stopCh)
	klog.V(2).Infof("Stopping reflector %s (%s) from %s", r.expectedTypeName, r.resyncPeriod, r.name)
}
2
3
4
5
6
7
8
9
10
11
12
13
所以不管我们传入的ListWatcher对象是如何实现的 List 和 Watch 操作,只要实现了就可以,最主要的还是看 ListAndWatch 函数是如何去实现的,如何去调用 List 和 Watch 的:
// k8s.io/client-go/tools/cache/reflector.go

// ListAndWatch 函数首先列出所有的对象,并在调用的时候获得资源版本,然后使用该资源版本来进行 watch 操作。
// 如果 ListAndWatch 没有初始化 watch 成功就会返回错误。
func (r *Reflector) ListAndWatch(stopCh <-chan struct{}) error {
	klog.V(3).Infof("Listing and watching %v from %s", r.expectedTypeName, r.name)
	var resourceVersion string

	options := metav1.ListOptions{ResourceVersion: r.relistResourceVersion()}

	if err := func() error {
		initTrace := trace.New("Reflector ListAndWatch", trace.Field{"name", r.name})
		defer initTrace.LogIfLong(10 * time.Second)
		var list runtime.Object
		var paginatedResult bool
		var err error
		listCh := make(chan struct{}, 1)
		panicCh := make(chan interface{}, 1)
		go func() {
			defer func() {
				if r := recover(); r != nil {
					panicCh <- r
				}
			}()
	    // 如果 listWatcher 支持,会尝试 chunks(分块)收集 List 列表数据
      // 如果不支持,第一个 List 列表请求将返回完整的响应数据。
			pager := pager.New(pager.SimplePageFunc(func(opts metav1.ListOptions) (runtime.Object, error) {
				return r.listerWatcher.List(opts)
			}))
			switch {
			case r.WatchListPageSize != 0:
				pager.PageSize = r.WatchListPageSize
			case r.paginatedResult:
        // 获得一个初始的分页结果。假定此资源和服务器符合分页请求,并保留默认的分页器大小设置
			case options.ResourceVersion != "" && options.ResourceVersion != "0":
				pager.PageSize = 0
			}

			list, paginatedResult, err = pager.List(context.Background(), options)
			if isExpiredError(err) {
				r.setIsLastSyncResourceVersionExpired(true)
				list, paginatedResult, err = pager.List(context.Background(), metav1.ListOptions{ResourceVersion: r.relistResourceVersion()})
			}
			close(listCh)
		}()
		select {
		case <-stopCh:
			return nil
		case r := <-panicCh:
			panic(r)
		case <-listCh:
		}
		if err != nil {
			return fmt.Errorf("%s: Failed to list %v: %v", r.name, r.expectedTypeName, err)
		}

		if options.ResourceVersion == "0" && paginatedResult {
			r.paginatedResult = true
		}

		r.setIsLastSyncResourceVersionExpired(false) // list 成功
		initTrace.Step("Objects listed")
		listMetaInterface, err := meta.ListAccessor(list)
		if err != nil {
			return fmt.Errorf("%s: Unable to understand list result %#v: %v", r.name, list, err)
		}
    // 获取资源版本号
		resourceVersion = listMetaInterface.GetResourceVersion()
		initTrace.Step("Resource version extracted")
    // 将资源数据转换成资源对象列表,将 runtime.Object 对象转换成 []runtime.Object 对象
		items, err := meta.ExtractList(list)
		if err != nil {
			return fmt.Errorf("%s: Unable to understand list result %#v (%v)", r.name, list, err)
		}
		initTrace.Step("Objects extracted")
    // 将资源对象列表中的资源对象和资源版本号存储在 Store 中
		if err := r.syncWith(items, resourceVersion); err != nil {
			return fmt.Errorf("%s: Unable to sync list result: %v", r.name, err)
		}
		initTrace.Step("SyncWith done")
		r.setLastSyncResourceVersion(resourceVersion)
		initTrace.Step("Resource version updated")
		return nil
	}(); err != nil {
		return err
	}

	resyncerrc := make(chan error, 1)
	cancelCh := make(chan struct{})
	defer close(cancelCh)
	go func() {
		resyncCh, cleanup := r.resyncChan()
		defer func() {
			cleanup()
		}()
		for {
			select {
			case <-resyncCh:
			case <-stopCh:
				return
			case <-cancelCh:
				return
			}
      // 如果 ShouldResync 为 nil 或者调用返回true,则执行 Store 的 Resync 操作
			if r.ShouldResync == nil || r.ShouldResync() {
				klog.V(4).Infof("%s: forcing resync", r.name)
				if err := r.store.Resync(); err != nil {
					resyncerrc <- err
					return
				}
			}
			cleanup()
			resyncCh, cleanup = r.resyncChan()
		}
	}()

	for {
		// stopCh 一个停止循环的机会
		select {
		case <-stopCh:
			return nil
		default:
		}

		timeoutSeconds := int64(minWatchTimeout.Seconds() * (rand.Float64() + 1.0))
		// 设置watch的选项,因为前期列举了全量对象,从这里只要监听最新版本以后的资源就可以了
    // 如果没有资源变化总不能一直挂着吧?也不知道是卡死了还是怎么了,所以设置一个超时会好一点
		options = metav1.ListOptions{
			ResourceVersion: resourceVersion,
			TimeoutSeconds: &timeoutSeconds,
			AllowWatchBookmarks: true,
		}

		start := r.clock.Now()
    // 执行 Watch 操作
		w, err := r.listerWatcher.Watch(options)
		if err != nil {
			switch {
			case isExpiredError(err):
				klog.V(4).Infof("%s: watch of %v closed with: %v", r.name, r.expectedTypeName, err)
			case err == io.EOF:
				// watch closed normally
			case err == io.ErrUnexpectedEOF:
				klog.V(1).Infof("%s: Watch for %v closed with unexpected EOF: %v", r.name, r.expectedTypeName, err)
			default:
				utilruntime.HandleError(fmt.Errorf("%s: Failed to watch %v: %v", r.name, r.expectedTypeName, err))
			}
			if utilnet.IsConnectionRefused(err) {
				time.Sleep(time.Second)
				continue
			}
			return nil
		}
		// 调用 watchHandler 来处理分发 watch 到的事件对象
		if err := r.watchHandler(start, w, &resourceVersion, resyncerrc, stopCh); err != nil {
			if err != errorStopRequested {
				switch {
				case isExpiredError(err):
					klog.V(4).Infof("%s: watch of %v closed with: %v", r.name, r.expectedTypeName, err)
				default:
					klog.Warningf("%s: watch of %v ended with: %v", r.name, r.expectedTypeName, err)
				}
			}
			return nil
		}
	}
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
上面的 ListAndWatch 函数实现看上去虽然非常复杂,但其实大部分是对分页的各种情况进行处理,最核心的还是调用 r.listerWatcher.List(opts) 获取全量的资源对象,而这个 List 其实 ListerWatcher 实现的 List 方法,这个 ListerWatcher 接口实际上在该接口定义的同一个文件中就有一个 ListWatch 结构体实现了:
// k8s.io/client-go/tools/cache/listwatch.go

// ListFunc 知道如何 List 资源
type ListFunc func(options metav1.ListOptions) (runtime.Object, error)

// WatchFunc 知道如何 watch 资源
type WatchFunc func(options metav1.ListOptions) (watch.Interface, error)

// ListWatch 结构体知道如何 list 和 watch 资源对象,它实现了 ListerWatcher 接口。
// 它为 NewReflector 使用者提供了方便的函数。其中 ListFunc 和 WatchFunc 不能为 nil。
type ListWatch struct {
	ListFunc  ListFunc
	WatchFunc WatchFunc
	// DisableChunking 对 list watcher 请求不分块。
	DisableChunking bool
}

// 列出一组 APIServer 资源
func (lw *ListWatch) List(options metav1.ListOptions) (runtime.Object, error) {
	return lw.ListFunc(options)
}

// Watch 一组 APIServer 资源
func (lw *ListWatch) Watch(options metav1.ListOptions) (watch.Interface, error) {
	return lw.WatchFunc(options)
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
当我们真正使用一个 Informer 对象的时候,实例化的时候就会调用这里的 ListWatch 来进行初始化
# 2.1.2 流程总结
比如我们要获取deployment资源
deployment Informer会向factory通过进行注册
调用上面的 NewFilteredDeploymentInformer 函数进行初始化,而在初始化的使用就传入了 cache.ListWatch 对象,其中就有 List 和 Watch 的实现操作
获取到了全量的 List 数据过后,通过
listMetaInterface.GetResourceVersion()来获取资源的版本号
ResourceVersion(资源版本号)非常重要,Kubernetes 中所有的资源都拥有该字段,它标识当前资源对象的版本号,每次修改(CUD)当前资源对象时,Kubernetes API Server 都会更改 ResourceVersion,这样 client-go 执行 Watch 操作时可以根据ResourceVersion 来确定当前资源对象是否发生了变化。
meta.ExtractList函数将资源数据转换成资源对象列表syncWith函数将资源对象列表中的资源对象和资源版本号存储在 Store 中- 通过
r.setLastSyncResourceVersion(resourceVersion)操作来设置最新的资源版本号,其他的就是启动一个 goroutine 去定期检查是否需要执行 Resync 操作,调用存储中的r.store.Resync()来执行 - Watch 操作通过 HTTP 协议与 APIServer 建立长连接,接收Kubernetes API Server 发来的资源变更事件,和 List 操作一样,Watch 的真正实现也是具体的 Informer 初始化的时候传入的
获得 watch 的资源数据后,通过调用 r.watchHandler 来处理资源的变更事件,当触发Add 事件、Update 事件、Delete 事件时,将对应的资源对象更新到本地缓存(DeltaFIFO)中并更新 ResourceVersion 资源版本号。
- 从上面的实现我们可以看出获取到的数据最终都流向了本地的 Store,也就是 DeltaFIFO,所以接下来我们需要来分析 DeltaFIFO 的实现
# 2.2 DeltaFIFO
前面我们讲到 Reflector 中通过 ListAndWatch 获取到数据后传入到了本地的存储中,也就是 DeltaFIFO 中。从 DeltaFIFO 的名字可以看出它是一个 FIFO,也就是一个先进先出的队列,而 Delta 表示的是变化的资源对象存储,包含操作资源对象的类型和数据,Reflector 就是这个队列的生产者。
在了解 DeltaFIFO 之前我们需要先具体了解下什么是 Delta,我们先来看看 client-go 中是如何定义的,Delta 的数据结构定义位于staging/src/k8s.io/client-go/tools/cache/delta_fifo.go文件中。
// k8s.io/client-go/tools/cache/delta_fifo.go

// DeltaType 是变化的类型(添加、删除等)
type DeltaType string

// 变化的类型定义
const (
	Added   DeltaType = "Added"     // 增加
	Updated DeltaType = "Updated"   // 更新
	Deleted DeltaType = "Deleted"   // 删除
	// 当遇到 watch 错误,不得不进行重新list时,就会触发 Replaced。
  // 我们不知道被替换的对象是否发生了变化。
	//
  // 注意:以前版本的 DeltaFIFO 也会对 Replace 事件使用 Sync。
  // 所以只有当选项 EmitDeltaTypeReplaced 为真时才会触发 Replaced。
	Replaced DeltaType = "Replaced"
	// Sync 是针对周期性重新同步期间的合成事件
	Sync DeltaType = "Sync"          // 同步
)

// Delta 是 DeltaFIFO 存储的类型。
// 它告诉你发生了什么变化,以及变化后对象的状态。
//
// [*] 除非变化是删除操作,否则你将得到对象被删除前的最终状态。
type Delta struct {
	Type   DeltaType
	Object interface{}
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28

其实也非常好理解,比如我们现在添加了一个 Pod,那么这个 Delta 就是带有 Added 这个类型的 Pod,如果是删除了一个 Deployment,那么这个 Delta 就是带有 Deleted 类型的 Deployment,为什么要带上类型呢?因为我们需要根据不同的类型去执行不同的操作,增加、更新、删除的动作显然是不一样的。
# 2.2.1 FIFO
FIFO 很好理解,就是一个先进先出的队列,Reflector 是其生产者,其数据结构定义位于 staging/src/k8s.io/client-go/tools/cache/fifo.go 文件中:
// k8s.io/client-go/tools/cache/fifo.go

type FIFO struct {
	lock sync.RWMutex
	cond sync.Cond

  // items 中的每一个 key 也在 queue 中
	items map[string]interface{}
	queue []string

	// 如果第一批 items 被 Replace() 插入或者先调用了 Deleta/Add/Update
  // 则 populated 为 true。
	populated bool
	// 第一次调用 Replace() 时插入的 items 数
	initialPopulationCount int

  // keyFunc 用于生成排队的 item 插入和检索的 key。
	keyFunc KeyFunc

  // 标识队列已关闭,以便在队列清空时控制循环可以退出。
	closed     bool
	closedLock sync.Mutex
}

var (
	_ = Queue(&FIFO{}) // FIFO 是一个 Queue
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
上面的 FIFO 数据结构中定义了 items 和 queue 两个属性来保存队列中的数据,其中 queue 中存的是资源对象的 key 列表,而 items 是一个 map 类型,其 key 就是 queue 中保存的 key,value 值是真正的资源对象数据。既然是先进进去的队列,那么就要具有队列的基本功能,结构体下面其实就有一个类型断言,表示当前的 FIFO 实现了 Queue 这个接口,所以 FIFO 要实现的功能都是在 Queue 中定义的,Queue 接口和 FIFO 位于同一文件中:
// k8s.io/client-go/tools/cache/fifo.go

// Queue 扩展了 Store  // with a collection of Store keys to "process".
// 每一次添加、更新或删除都可以将对象的key放入到该集合中。
// Queue 具有使用给定的 accumulator 来推导出相应的 key 的方法
// Queue 可以从多个 goroutine 中并发访问
// Queue 可以被关闭,之后 Pop 操作会返回一个错误
type Queue interface {
	Store

	// Pop 一直阻塞,直到至少有一个key要处理或队列被关闭,队列被关闭会返回一个错误。
  // 在前面的情况下 Pop 原子性地选择一个 key 进行处理,从 Store 中删除关联(key、accumulator)的数据,
  // 并处理 accumulator。Pop 会返回被处理的 accumulator 和处理的结果。

	// PopProcessFunc 函数可以返回一个 ErrRequeue{inner},在这种情况下,Pop 将
  //(a)把那个(key,accumulator)关联作为原子处理的一部分返回到 Queue 中
  // (b) 从 Pop 返回内部错误。
	Pop(PopProcessFunc) (interface{}, error)

	// 仅当该 key 尚未与一个非空的 accumulator 相关联的时候,AddIfNotPresent 将给定的 accumulator 放入 Queue(与 accumulator 的 key 相关联的)
	AddIfNotPresent(interface{}) error

  // 如果第一批 keys 都已经 Popped,则 HasSynced 返回 true。
  // 如果在添加、更新、删除之前发生了第一次 Replace 操作,则第一批 keys 为 true
  // 否则为空。
	HasSynced() bool

	// 关闭该队列
	Close()
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
从上面的定义中可以看出 Queue 这个接口扩展了 Store 这个接口,这个就是前面我们说的本地存储,队列实际上也是一种存储,然后在 Store 的基础上增加 Pop、AddIfNotPresent、HasSynced、Close 4个函数就变成了 Queue 队列了,所以我们优先来看下 Store 这个接口的定义,该数据结构定义位于文件 k8s.io/client-go/tools/cache/store.go 中
// k8s.io/client-go/tools/cache/store.go

// Store 是一个通用的对象存储和处理的接口。
// Store 包含一个从字符串 keys 到 accumulators 的映射,并具有 to/from 当前
// 给定 key 关联的 accumulators 添加、更新和删除给定对象的操作。
// 一个 Store 还知道如何从给定的对象中获取 key,所以很多操作只提供对象。
//
// 在最简单的 Store 实现中,每个 accumulator 只是最后指定的对象,或者删除后为空,
// 所以 Store 只是简单的存储。
//
// Reflector 反射器知道如何 watch 一个服务并更新一个 Store 存储,这个包提供了 Store 的各种实现。
type Store interface {

	// Add 将指定对象添加到与指定对象的 key 相关的 accumulator(累加器)中。
	Add(obj interface{}) error

	// Update 与指定对象的 key 相关的 accumulator 中更新指定的对象
	Update(obj interface{}) error

	// Delete 根据指定的对象 key 删除指定的对象
	Delete(obj interface{}) error

	// List 返回当前所有非空的 accumulators 的列表
	List() []interface{}

	// ListKeys 返回当前与非空 accumulators 关联的所有 key 的列表
	ListKeys() []string

	// Get 根据指定的对象获取关联的 accumulator
	Get(obj interface{}) (item interface{}, exists bool, err error)

	// GetByKey 根据指定的对象 key 获取关联的 accumulator
	GetByKey(key string) (item interface{}, exists bool, err error)

	// Replace 会删除原来Store中的内容,并将新增的list的内容存入Store中,即完全替换数据
  // Store 拥有 list 列表的所有权,在调用此函数后,不应该引用它了。
	Replace([]interface{}, string) error

	// Resync 在 Store 中没有意义,但是在 DeltaFIFO 中有意义。
	Resync() error
}

// KeyFunc 就是从一个对象中生成一个唯一的 Key 的函数,上面的 FIFO 中就有用到
type KeyFunc func(obj interface{}) (string, error)

// MetaNamespaceKeyFunc 是默认的 KeyFunc,生成的 key 格式为:
// <namespace>/<name>
// 如果是全局的,则namespace为空,那么生成的 key 就是 <name>
// 当然要从 key 拆分出 namespace 和 name 也非常简单
func MetaNamespaceKeyFunc(obj interface{}) (string, error) {
	if key, ok := obj.(ExplicitKey); ok {
		return string(key), nil
	}
	meta, err := meta.Accessor(obj)
	if err != nil {
		return "", fmt.Errorf("object has no meta: %v", err)
	}
	if len(meta.GetNamespace()) > 0 {
		return meta.GetNamespace() + "/" + meta.GetName(), nil
	}
	return meta.GetName(), nil
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
Store 就是一个通用的对象存储和处理的接口,可以用来写入对象和获取对象。其中 cache 数据结构就实现了上面的 Store 接口,但是这个属于后面的 Indexer 部分的知识点,这里我们就不展开说明了。
我们说 Queue 扩展了 Store 接口,所以 Queue 本身也是一个存储,只是在存储的基础上增加了 Pop 这样的函数来实现弹出对象,是不是就变成了一个队列了。
接下来看看 FIFO 是如何实现存储和 Pop 的功能的。首先是实现 Store 存储中最基本的方法,第一个就是添加对象:
更新对象,实现非常简单,因为上面的 Add 方法就包含了 Update 的实现,因为 items 属性是一个 Map,对象有更新直接将对应 key 的 value 值替换成新的对象即可:
// k8s.io/client-go/tools/cache/fifo.go

// Update 和 Add 相同的实现
func (f *FIFO) Update(obj interface{}) error {
	return f.Add(obj)
}
2
3
4
5
6
接着就是删除 Delete 方法的实现,这里可能大家会有一个疑问,下面的删除实现只删除了 items 中的元素,那这样岂不是 queue 和 items 中的 key 会不一致吗?的确会这样,但是这是一个队列,下面的 Pop() 函数会根据 queue 里面的元素一个一个的弹出 key,没有对象就不处理了,相当于下面的 Pop() 函数中实现了 queue 的 key 的删除:
// k8s.io/client-go/tools/cache/fifo.go

// Delete 从队列中移除一个对象。
// 不会添加到 queue 中去,这个实现是假设消费者只关心对象
// 不关心它们被创建或添加的顺序。
func (f *FIFO) Delete(obj interface{}) error {
  // 获取对象的 key
	id, err := f.keyFunc(obj)
	if err != nil {
		return KeyError{obj, err}
	}
	f.lock.Lock()
	defer f.lock.Unlock()
	f.populated = true
  // 删除 items 中 key 为 id 的元素,就是删除队列中的对象
	delete(f.items, id)
  //?为什么不直接处理 queue 这个 slice 呢?
	return err
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
然后是获取队列中所有对象的 List 方法的实现:
// k8s.io/client-go/tools/cache/fifo.go

// List 获取队列中的所有对象
func (f *FIFO) List() []interface{} {
	f.lock.RLock()
	defer f.lock.RUnlock()
	list := make([]interface{}, 0, len(f.items))
  // 获取所有的items的values值(items是一个Map)
	for _, item := range f.items {
		list = append(list, item)
	}
	return list
}
2
3
4
5
6
7
8
9
10
11
12
13
接着是获取队列中所有元素的 key 的 ListKeys 方法实现:
// k8s.io/client-go/tools/cache/fifo.go

// ListKeys 返回现在 FIFO 队列中所有对象的 keys 列表。
func (f *FIFO) ListKeys() []string {
	f.lock.RLock()
	defer f.lock.RUnlock()
	list := make([]string, 0, len(f.items))
  // 获取所有items的key值(items是一个Map)
	for key := range f.items {
		list = append(list, key)
	}
	return list
}
2
3
4
5
6
7
8
9
10
11
12
13
至于根据对象或者对象的 key 获取队列中的元素,就更简单了:
// k8s.io/client-go/tools/cache/fifo.go

// Get 获取指定对象在队列中的元素
func (f *FIFO) Get(obj interface{}) (item interface{}, exists bool, err error) {
	key, err := f.keyFunc(obj)
	if err != nil {
		return nil, false, KeyError{obj, err}
	}
  // 调用 GetByKey 实现
	return f.GetByKey(key)
}

// GetByKey 根据 key 获取队列中的元素
func (f *FIFO) GetByKey(key string) (item interface{}, exists bool, err error) {
	f.lock.RLock()
	defer f.lock.RUnlock()
  // 因为 items 是一个 Map,所以直接根据 key 获取即可
	item, exists = f.items[key]
	return item, exists, nil
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
然后是一个 Replace 替换函数的实现:
// k8s.io/client-go/tools/cache/fifo.go

// Replace 将删除队列中的内容,'f' 拥有 map 的所有权,调用该函数过后,不应该再引用 map。
// 'f' 的队列也会被重置,返回时,队列将包含 map 中的元素,没有特定的顺序。
func (f *FIFO) Replace(list []interface{}, resourceVersion string) error {
	// 从 list 中提取出 key 然后和里面的元素重新进行映射
  items := make(map[string]interface{}, len(list))
	for _, item := range list {
		key, err := f.keyFunc(item)
		if err != nil {
			return KeyError{item, err}
		}
		items[key] = item
	}

	f.lock.Lock()
	defer f.lock.Unlock()

	if !f.populated {
		f.populated = true
		f.initialPopulationCount = len(items)
	}
	// 重新设置 items 和 queue 的值
	f.items = items
	f.queue = f.queue[:0]
	for id := range items {
		f.queue = append(f.queue, id)
	}
	if len(f.queue) > 0 {
		f.cond.Broadcast()
	}
	return nil
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
还有 Store 存储中的最后一个方法 Resync 的实现:
// k8s.io/client-go/tools/cache/fifo.go

// Resync 会保证 Store 中的每个对象在 queue 中都有它的 key。
//
// 这应该是禁止操作的,因为该属性由所有操作维护
func (f *FIFO) Resync() error {
	f.lock.Lock()
	defer f.lock.Unlock()
  // 将所有 queue 中的元素放到一个 set 中
	inQueue := sets.NewString()
	for _, id := range f.queue {
		inQueue.Insert(id)
	}
  // 然后将所有 items 中的 key 加回到 queue 中去
	for id := range f.items {
		if !inQueue.Has(id) {
			f.queue = append(f.queue, id)
		}
	}
	if len(f.queue) > 0 {
		f.cond.Broadcast()
	}
	return nil
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
上面的所有方法就实现了一个普通的 Store,然后要想变成一个 Queue,还需要实现额外的 Pop 方法:
// k8s.io/client-go/tools/cache/fifo.go

// Pop 会等到一个元素准备好后再进行处理,如果有多个元素准备好了,则按照它们被添加或更新的顺序返回。
//
// 在处理之前,元素会从队列(和存储)中移除,所以如果没有成功处理,应该用 AddIfNotPresent() 函数把它添加回来。
// 处理函数是在有锁的情况下调用的,所以更新其中需要和队列同步的数据结构是安全的。
func (f *FIFO) Pop(process PopProcessFunc) (interface{}, error) {
	f.lock.Lock()
	defer f.lock.Unlock()
	for {
		// 当队列为空时,Pop() 的调用会被阻塞住,直到新的元素插入队列后
		for len(f.queue) == 0 {
			if f.IsClosed() {
				return nil, ErrFIFOClosed
			}
			// 等待 condition 被广播
			f.cond.Wait()
		}
    // 取出 queue 队列中的第一个元素(key)
		id := f.queue[0]
    // 删除第一个元素
		f.queue = f.queue[1:]
		if f.initialPopulationCount > 0 {
			f.initialPopulationCount--
		}
    // 获取被弹出的元素
		item, ok := f.items[id]
		if !ok {
			// 因为 item 可能已经被删除了。
			continue
		}
    // 删除弹出的元素
		delete(f.items, id)
    // 处理弹出的元素
		err := process(item)
		if e, ok := err.(ErrRequeue); ok {
      // 如果处理没成功,需要调用 addIfNotPresent 加回队列
			f.addIfNotPresent(id, item)
			err = e.Err
		}
		return item, err
	}
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
另外的一个就是上面提到的 AddIfNotPresent、HasSynced、Close 几个函数的实现:
// k8s.io/client-go/tools/cache/fifo.go

// AddIfNotPresent 插入一个元素,将其放入队列中。
// 如果元素已经在集合中了,则会被忽略。
//
// 这在单个的 生产者/消费者 的场景下非常有用,这样消费者可以安全地重试
// 而不需要与生产者争夺,也不需要排队等待过时的元素。
func (f *FIFO) AddIfNotPresent(obj interface{}) error {
	id, err := f.keyFunc(obj)  // 获取对象的 key
	if err != nil {
		return KeyError{obj, err}
	}
	f.lock.Lock()
	defer f.lock.Unlock()
	f.addIfNotPresent(id, obj)  // 调用 addIfNotPresent 真正的实现
	return nil
}

// addIfNotPresent 会假设已经持有 fifo 锁了,如果不存在,则将其添加到队列中去。
func (f *FIFO) addIfNotPresent(id string, obj interface{}) {
	f.populated = true
  // 存在则忽略
	if _, exists := f.items[id]; exists {
		return
	}
  // 添加到 queue 和 items 中去
	f.queue = append(f.queue, id)
	f.items[id] = obj
  // 广播 condition
	f.cond.Broadcast()
}

// 关闭队列
func (f *FIFO) Close() {
	f.closedLock.Lock()
	defer f.closedLock.Unlock()
  // 标记为关闭
	f.closed = true
	f.cond.Broadcast()
}

// 如果先调用了 Add/Update/Delete/AddIfNotPresent,或者先调用了Update,但被 Replace() 插入的第一批元素已经被弹出,则 HasSynced 返回true。
func (f *FIFO) HasSynced() bool {
	f.lock.Lock()
	defer f.lock.Unlock()
	return f.populated && f.initialPopulationCount == 0
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
到这里我们就实现了一个简单的 FIFO 队列,其实这里就是对 FIFO 这个数据结构的理解,没有特别的地方,只是在队列里面有 items 和 queue 两个属性来维护队列而已。
# 2.2.3 FIFo demo
package fifo_demo

import (
	"testing"
	"time"
)

type testFifoObject struct {
	name string
	val  interface{}
}

func testFifoObjectKeyFunc(obj interface{}) (string, error) {
	return obj.(testFifoObject).name, nil
}

func TestFIFO_requeueOnPop(t *testing.T) {
	f := NewFIFO(testFifoObjectKeyFunc)
	var testData = []testFifoObject{
		{name: "test", val: 10},
		{name: "test2", val: 10},
		{name: "test3", val: 10},
		{name: "tes4", val: 10},
	}
	for _, test := range testData {
		f.Add(test)
		time.Sleep(3 * time.Second)
	}
	for i := 0; i < len(testData); i++ {
		t.Logf("keys : %v", f.ListKeys())
		data := Pop(f)
		t.Log(data)
	}
	item, ok, err := f.Get(testFifoObject{name: "test", val: 10})
	t.Log(item, ok, err)
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
# 2.2.4 DeltaFIFO
上面我们已经实现了 FIFO,接下来就看下一个 DeltaFIFO 是如何实现的,DeltaFIFO 和 FIFO 一样也是一个队列,但是也有不同的地方,里面的元素是一个 Delta,Delta 上面我们已经提到表示的是带有变化类型的资源对象。
DeltaFIFO 的数据结构定义位于 staging/src/k8s.io/client-go/tools/cache/delta_fifo.go 文件中:
// k8s.io/client-go/tools/cache/delta_fifo.go

type DeltaFIFO struct {
	// lock/cond 保护访问的 items 和 queue
	lock sync.RWMutex
	cond sync.Cond

  // 用来存储 Delta 数据 -> 对象key: Delta数组

	items map[string]Deltas
  // 用来存储资源对象的key
	queue []string

	// 通过 Replace() 接口将第一批对象放入队列,或者第一次调用增、删、改接口时标记为true
	populated bool
	// 通过 Replace() 接口(全量)将第一批对象放入队列的对象数量
	initialPopulationCount int

	// 对象键的计算函数
	keyFunc KeyFunc

	// knownObjects 列出 "known" 的键 -- 影响到 Delete(),Replace() 和 Resync()
  // knownObjects 其实就是 Indexer,里面存有已知全部的对象
	knownObjects KeyListerGetter

	// 标记 queue 被关闭了
  closed     bool
	closedLock sync.Mutex

	// emitDeltaTypeReplaced 当 Replace() 被调用的时候,是否要 emit Replaced 或者 Sync
	// DeltaType(保留向后兼容)。
	emitDeltaTypeReplaced bool
}

// KeyListerGetter 任何知道如何列出键和按键获取对象的东西
type KeyListerGetter interface {
	KeyLister
	KeyGetter
}

// 获取所有的键
type KeyLister interface {
	ListKeys() []string
}

// 根据键获取对象
type KeyGetter interface {
	GetByKey(key string) (interface{}, bool, error)
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
DeltaFIFO 与 FIFO 一样都是一个 Queue,所以他们都实现了 Queue,所以我们这里来看下 DeltaFIFO 是如何实现 Queue 功能的,当然和 FIFO 一样都是实现 Queue 接口里面的所有方法。
虽然实现流程和 FIFO 是一样的,但是具体的实现是不一样的,比如 DeltaFIFO 的对象键计算函数就不同:
// k8s.io/client-go/tools/cache/delta_fifo.go

// DeltaFIFO 的对象键计算函数
func (f *DeltaFIFO) KeyOf(obj interface{}) (string, error) {
	// 用 Deltas 做一次转换,判断是否是 Delta 切片
  if d, ok := obj.(Deltas); ok {
		if len(d) == 0 {
			return "", KeyError{obj, ErrZeroLengthDeltasObject}
		}
    // 使用最新版本的对象进行计算
		obj = d.Newest().Object
	}
	if d, ok := obj.(DeletedFinalStateUnknown); ok {
		return d.Key, nil
	}
  // 具体计算还是要看初始化 DeltaFIFO 传入的 KeyFunc 函数
	return f.keyFunc(obj)
}

// Newest 返回最新的 Delta,如果没有则返回 nil。
func (d Deltas) Newest() *Delta {
	if n := len(d); n > 0 {
		return &d[n-1]
	}
	return nil
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
DeltaFIFO 的计算对象键的函数为什么要先做一次 Deltas 的类型转换呢?那是因为 Pop() 出去的对象很可能还要再添加进来(比如处理失败需要再放进来),此时添加的对象就是已经封装好的 Deltas 对象了。
然后同样按照上面的方式来分析 DeltaFIFO 的实现,首先查看 Store 存储部分的实现,也就是增、删、改、查功能。
同样的 Add、Update 和 Delete 的实现方法基本上是一致的:
// k8s.io/client-go/tools/cache/delta_fifo.go

// Add 插入一个元素放入到队列中
func (f *DeltaFIFO) Add(obj interface{}) error {
	f.lock.Lock()
	defer f.lock.Unlock()
	f.populated = true  // 队列第一次写入操作都要设置标记
	return f.queueActionLocked(Added, obj)
}

// Update 和 Add 一样,只是是 Updated 一个 Delta
func (f *DeltaFIFO) Update(obj interface{}) error {
	f.lock.Lock()
	defer f.lock.Unlock()
	f.populated = true  // 队列第一次写入操作都要设置标记
	return f.queueActionLocked(Updated, obj)
}

// 删除和添加一样,但会产生一个删除的 Delta。如果给定的对象还不存在,它将被忽略。
// 例如,它可能已经被替换(重新list)删除了。
// 在这个方法中,`f.knownObjects` 如果不为nil,则提供(通过GetByKey)被认为已经存在的 _additional_ 对象。
func (f *DeltaFIFO) Delete(obj interface{}) error {
	id, err := f.KeyOf(obj)
	if err != nil {
		return KeyError{obj, err}
	}
	f.lock.Lock()
	defer f.lock.Unlock()
  // 队列第一次写入操作都要设置这个标记
	f.populated = true
  // 相当于没有 Indexer 的时候,就通过自己的存储对象检查下
	if f.knownObjects == nil {
		if _, exists := f.items[id]; !exists {
			// 自己的存储里面都没有,那也就不用处理了
			return nil
		}
	} else
		// 相当于 Indexer 里面和自己的存储里面都没有这个对象,那么也就相当于不存在了,就不处理了。
    _, exists, err := f.knownObjects.GetByKey(id)
		_, itemsExist := f.items[id]
		if err == nil && !exists && !itemsExist {
			return nil
		}
	}
  // 同样调用 queueActionLocked 将数据放入队列
	return f.queueActionLocked(Deleted, obj)
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
可以看出 Add 、Update、Delete 方法最终都是调用的 queueActionLocked 函数来实现:
// k8s.io/client-go/tools/cache/delta_fifo.go

// queueActionLocked 追加到对象的 delta 列表中。
// 调用者必须先 lock。
func (f *DeltaFIFO) queueActionLocked(actionType DeltaType, obj interface{}) error {
	id, err := f.KeyOf(obj)  // 获取对象键
	if err != nil {
		return KeyError{obj, err}
	}

  // 将 actionType 和资源对象 obj 构造成 Delta,添加到 items 中
	newDeltas := append(f.items[id], Delta{actionType, obj})
  // 去重
	newDeltas = dedupDeltas(newDeltas)

	if len(newDeltas) > 0 {
    // 新对象的 key 不在队列中则插入 queue 队列
		if _, exists := f.items[id]; !exists {
			f.queue = append(f.queue, id)
		}
    // 重新更新 items
		f.items[id] = newDeltas
    // 通知所有的消费者解除阻塞
		f.cond.Broadcast()
	} else {
    // 这种情况不会发生,因为给定一个非空列表时,dedupDeltas 永远不会返回一个空列表。
    // 但如果真的返回了一个空列表,那么我们就需要从 map 中删除这个元素。
		delete(f.items, id)
	}
	return nil
}

// ==============排重==============
// 重新list和watch可以以任何顺序多次提供相同的更新。
// 如果最近的两个 Delta 相同,则将它们合并。
func dedupDeltas(deltas Deltas) Deltas {
	n := len(deltas)
	if n < 2 {  // 小于两个 delta 没必要合并了
		return deltas
	}
  // Deltas是[]Delta,新的对象是追加到Slice后面
  // 所以取最后两个元素来判断是否相同
	a := &deltas[n-1]
	b := &deltas[n-2]
  // 执行去重操作
	if out := isDup(a, b); out != nil {
    // 将去重保留下来的delta追加到前面n-2个delta中去
		d := append(Deltas{}, deltas[:n-2]...)
		return append(d, *out)
	}
	return deltas
}

// 判断两个 Delta 是否是重复的
func isDup(a, b *Delta) *Delta {
  // 这个函数应该应该可以判断多种类型的重复,目前只有删除这一种能够合并
	if out := isDeletionDup(a, b); out != nil {
		return out
	}
	return nil
}

// 判断是否为删除类型的重复
func isDeletionDup(a, b *Delta) *Delta {
  // 二者类型都是删除那肯定有一个是重复的,则返回一个即可
	if b.Type != Deleted || a.Type != Deleted {
		return nil
	}
	// 更复杂的检查还是这样就够了?
	if _, ok := b.Object.(DeletedFinalStateUnknown); ok {
		return a
	}
	return b
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
因为系统对于删除的对象有 DeletedFinalStateUnknown 这个状态,所以会存在两次删除的情况,但是两次添加同一个对象由于 APIServer 可以保证对象的唯一性,所以这里没有考虑合并两次添加操作的情况。
然后看看其他几个主要方法的实现:
// k8s.io/client-go/tools/cache/delta_fifo.go

// 列举接口实现
func (f *DeltaFIFO) List() []interface{} {
	f.lock.RLock()
	defer f.lock.RUnlock()
	return f.listLocked()
}
// 真正的列举实现
func (f *DeltaFIFO) listLocked() []interface{} {
	list := make([]interface{}, 0, len(f.items))
	for _, item := range f.items {
		list = append(list, item.Newest().Object)
	}
	return list
}

// 返回现在 FIFO 中所有的对象键。
func (f *DeltaFIFO) ListKeys() []string {
	f.lock.RLock()
	defer f.lock.RUnlock()
	list := make([]string, 0, len(f.items))
	for key := range f.items {
		list = append(list, key)
	}
	return list
}

// 根据对象获取FIFO中对应的元素
func (f *DeltaFIFO) Get(obj interface{}) (item interface{}, exists bool, err error) {
	key, err := f.KeyOf(obj)
	if err != nil {
		return nil, false, KeyError{obj, err}
	}
	return f.GetByKey(key)
}

// 通过对象键获取FIFO中的元素(获取到的是 Delta 数组)
func (f *DeltaFIFO) GetByKey(key string) (item interface{}, exists bool, err error) {
	f.lock.RLock()
	defer f.lock.RUnlock()
	d, exists := f.items[key]
	if exists {
		// 复制元素的slice,这样对这个切片的操作就不会影响返回的对象了。
		d = copyDeltas(d)
	}
	return d, exists, nil
}

// copyDeltas 返回 d 的浅拷贝,也就是说它拷贝的是切片,而不是切片中的对象。
// Get/List 可以返回一个不会被后续修改影响的对象。
func copyDeltas(d Deltas) Deltas {
	d2 := make(Deltas, len(d))
	copy(d2, d)
	return d2
}

// 判断队列是否关闭了
func (f *DeltaFIFO) IsClosed() bool {
	f.closedLock.Lock()
	defer f.closedLock.Unlock()
	return f.closed
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
接下来我们来看看 Replace 函数的时候,这个也是 Store 里面的定义的接口:
// k8s.io/client-go/tools/cache/delta_fifo.go

func (f *DeltaFIFO) Replace(list []interface{}, resourceVersion string) error {
	f.lock.Lock()
	defer f.lock.Unlock()
	keys := make(sets.String, len(list))

	// keep 对老客户端的向后兼容
	action := Sync
	if f.emitDeltaTypeReplaced {
		action = Replaced
	}
  // 遍历 list
	for _, item := range list {
    // 计算对象键
		key, err := f.KeyOf(item)
		if err != nil {
			return KeyError{item, err}
		}
    // 记录处理过的对象键,使用 set 集合存储
		keys.Insert(key)
    // 重新同步一次对象
		if err := f.queueActionLocked(action, item); err != nil {
			return fmt.Errorf("couldn't enqueue object: %v", err)
		}
	}
  // 如果没有 Indexer 存储的话,自己存储的就是所有的老对象
  // 目的要看看那些老对象不在全量集合中,那么就是删除的对象了
	if f.knownObjects == nil {
		// 针对自己的列表进行删除检测。
		queuedDeletions := 0
    // 遍历所有元素
		for k, oldItem := range f.items {
      // 如果元素在输入的对象中存在就忽略了。
			if keys.Has(k) {
				continue
			}
      // 到这里证明当前的 oldItem 元素不在输入的列表中,证明对象已经被删除了
			var deletedObj interface{}
			if n := oldItem.Newest(); n != nil {
				deletedObj = n.Object
			}
			queuedDeletions++
      // 因为可能队列中已经存在 Deleted 类型的元素了,避免重复,所以采用 DeletedFinalStateUnknown 来包装下对象
			if err := f.queueActionLocked(Deleted, DeletedFinalStateUnknown{k, deletedObj}); err != nil {
				return err
			}
		}
    // 如果 populated 没有设置,说明是第一次并且还没有任何修改操作执行过
		if !f.populated {
      // 这个时候需要标记下
			f.populated = true
			// 记录第一次设置的对象数量
			f.initialPopulationCount = len(list) + queuedDeletions
		}

		return nil
	}

  // 检测已经删除但是没有在队列中的元素。
  // 从 Indexer 中获取所有的对象键
	knownKeys := f.knownObjects.ListKeys()
	queuedDeletions := 0
	for _, k := range knownKeys {
    // 对象存在就忽略
		if keys.Has(k) {
			continue
		}
    // 到这里同样证明当前的对象键对应的对象被删除了
    // 获取被删除的对象键对应的对象
		deletedObj, exists, err := f.knownObjects.GetByKey(k)
		if err != nil {
			deletedObj = nil
			klog.Errorf("Unexpected error %v during lookup of key %v, placing DeleteFinalStateUnknown marker without object", err, k)
		} else if !exists {
			deletedObj = nil
			klog.Infof("Key %v does not exist in known objects store, placing DeleteFinalStateUnknown marker without object", k)
		}
    // 累加删除的对象数量
		queuedDeletions++
    // 把对象删除的 Delta 放入队列,和上面一样避免重复,使用 DeletedFinalStateUnknown 包装下对象
		if err := f.queueActionLocked(Deleted, DeletedFinalStateUnknown{k, deletedObj}); err != nil {
			return err
		}
	}
  // 和上面一致
	if !f.populated {
		f.populated = true
		f.initialPopulationCount = len(list) + queuedDeletions
	}

	return nil
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
到这里我们就将完整实现了 DeltaFIFO,然后加上前面的 Reflector 反射器,就可以结合起来了:
# 2.2.5 流程总结
Reflector 通过 ListAndWatch 首先获取全量的资源对象数据,然后调用 DeltaFIFO 的 Replace() 方法全量插入队列,然后后续通过 Watch 操作根据资源对象的操作类型调用 DeltaFIFO 的 Add、Update、Delete 方法,将数据更新到队列中。我们可以用下图来总结这两个组件之间的关系:

至于 Pop 出来的元素如何处理,就要看 Pop 的回调函数 PopProcessFunc 了。我们可以回到最初的 SharedInformer 中,在 sharedIndexInformer 的 Run 函数中就初始化了 DeltaFIFO,也配置了用于 Pop 回调处理的函数:
func (s *sharedIndexInformer) Run(stopCh <-chan struct{}) {
	defer utilruntime.HandleCrash()
  // 初始化 DeltaFIFO,这里就可以看出来 KnownObjects 就是一个 Indexer
	fifo := NewDeltaFIFOWithOptions(DeltaFIFOOptions{
		KnownObjects:          s.indexer,
		EmitDeltaTypeReplaced: true,
	})

	cfg := &Config{
		Queue:            fifo,
		ListerWatcher:    s.listerWatcher,
		ObjectType:       s.objectType,
		FullResyncPeriod: s.resyncCheckPeriod,
		RetryOnError:     false,
		ShouldResync:     s.processor.shouldResync,

		Process: s.HandleDeltas,  // 指定 Pop 函数的回调处理函数
	}
	......
}

// 真正的 Pop 回调处理函数
func (s *sharedIndexInformer) HandleDeltas(obj interface{}) error {
	s.blockDeltas.Lock()
	defer s.blockDeltas.Unlock()

	// from oldest to newest
	for _, d := range obj.(Deltas) {
		switch d.Type {
		case Sync, Replaced, Added, Updated:
			s.cacheMutationDetector.AddObject(d.Object)
			if old, exists, err := s.indexer.Get(d.Object); err == nil && exists {
				......
			} else {
        // 将对象添加到 Indexer 中
				if err := s.indexer.Add(d.Object); err != nil {
					return err
				}
				......
			}
		case Deleted:
      // 删除 Indexer 中的对象
			if err := s.indexer.Delete(d.Object); err != nil {
				return err
			}
			......
		}
	}
	return nil
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
从上面可以看出 DeltaFIFO 中的元素被弹出来后被同步到了 Indexer 存储中,而在 DeltaFIFO 中的 KnownObjects 也就是这个指定的 Indexer,所以接下来我们就需要重点分析 Indexer 组件的实现了。
# 2.3 Indexer

上节课我们讲到 DeltaFIFO 中的元素通过 Pop 函数弹出后,在指定的回调函数中将元素添加到了 Indexer 中。Indexer 是什么?字面意思是索引器,它就是 Informer 中的 LocalStore 部分,我们可以和数据库进行类比,数据库是建立在存储之上的,索引也是构建在存储之上,只是和数据做了一个映射,使得按照某些条件查询速度会非常快,所以说 Indexer 本身也是一个存储,只是它在存储的基础上扩展了索引功能。从 Indexer 接口的定义可以证明这一点:
在去查看 Indexer 的接口具体实现之前,我们需要了解 Indexer 中几个非常重要的概念:Indices、Index、Indexers 及 IndexFunc。

// k8s.io/client-go/tools/cache/indexer.go

// 用于计算一个对象的索引键集合
type IndexFunc func(obj interface{}) ([]string, error)

// 索引键与对象键集合的映射
type Index map[string]sets.String

// 索引器名称与 IndexFunc 的映射,相当于存储索引的各种分类
type Indexers map[string]IndexFunc

// 索引器名称与 Index 索引的映射
type Indices map[string]Index
2
3
4
5
6
7
8
9
10
11
12
13
这4个数据结构的命名非常容易让大家混淆,直接查看源码也不是那么容易的。这里我们来仔细解释下。首先什么叫索引,索引就是为了快速查找的,比如我们需要查找某个节点上的所有 Pod,那就让 Pod 按照节点名称排序列举出来,对应的就是 Index 这个类型,具体的就是 map[node]sets.pod,但是如何去查找可以有多种方式,就是上面的 Indexers 这个类型的作用。我们可以用一个比较具体的示例来解释他们的关系和含义,如下所示:
package main

import (
	"fmt"

	v1 "k8s.io/api/core/v1"
	"k8s.io/apimachinery/pkg/api/meta"
	metav1 "k8s.io/apimachinery/pkg/apis/meta/v1"
	"k8s.io/client-go/tools/cache"
)

const (
	NamespaceIndexName = "namespace"
	NodeNameIndexName  = "nodeName"
)

func NamespaceIndexFunc(obj interface{}) ([]string, error) {
	m, err := meta.Accessor(obj)
	if err != nil {
		return []string{""}, fmt.Errorf("object has no meta: %v", err)
	}
	return []string{m.GetNamespace()}, nil
}

func NodeNameIndexFunc(obj interface{}) ([]string, error) {
	pod, ok := obj.(*v1.Pod)
	if !ok {
		return []string{}, nil
	}
	return []string{pod.Spec.NodeName}, nil
}

func main() {
	index := cache.NewIndexer(cache.MetaNamespaceKeyFunc, cache.Indexers{
		NamespaceIndexName: NamespaceIndexFunc,
		NodeNameIndexName:  NodeNameIndexFunc,
	})

	pod1 := &v1.Pod{
		ObjectMeta: metav1.ObjectMeta{
			Name:      "index-pod-1",
			Namespace: "default",
		},
		Spec: v1.PodSpec{NodeName: "node1"},
	}
	pod2 := &v1.Pod{
		ObjectMeta: metav1.ObjectMeta{
			Name:      "index-pod-2",
			Namespace: "default",
		},
		Spec: v1.PodSpec{NodeName: "node2"},
	}
	pod3 := &v1.Pod{
		ObjectMeta: metav1.ObjectMeta{
			Name:      "index-pod-3",
			Namespace: "kube-system",
		},
		Spec: v1.PodSpec{NodeName: "node2"},
	}

	_ = index.Add(pod1)
	_ = index.Add(pod2)
	_ = index.Add(pod3)

	// ByIndex 两个参数:IndexName(索引器名称)和 indexKey(需要检索的key)
	pods, err := index.ByIndex(NamespaceIndexName, "default")
	if err != nil {
		panic(err)
	}
	for _, pod := range pods {
		fmt.Println(pod.(*v1.Pod).Name)
	}

	fmt.Println("==========================")

	pods, err = index.ByIndex(NodeNameIndexName, "node2")
	if err != nil {
		panic(err)
	}
	for _, pod := range pods {
		fmt.Println(pod.(*v1.Pod).Name)
	}

}

// 输出结果为:
index-pod-1
index-pod-2
==========================
index-pod-2
index-pod-3
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
在上面的示例中首先通过 NewIndexer 函数实例化 Indexer 对象,第一个参数就是用于计算资源对象键的函数,这里我们使用的是 MetaNamespaceKeyFunc 这个默认的对象键函数;第二个参数是 Indexers,也就是存储索引器,上面我们知道 Indexers 的定义为 map[string]IndexFunc,为什么要定义成一个 map 呢?我们可以类比数据库中,我们要查询某项数据,索引的方式是不是多种多样啊?为了扩展,Kubernetes 中就使用一个 map 来存储各种各样的存储索引器,至于存储索引器如何生成,就使用一个 IndexFunc 暴露出去,给使用者自己实现即可。
这里我们定义的了两个索引键生成函数: NamespaceIndexFunc 与 NodeNameIndexFunc,一个根据资源对象的命名空间来进行索引,一个根据资源对象所在的节点进行索引。然后定义了3个 Pod,前两个在 default 命名空间下面,另外一个在 kube-system 命名空间下面,然后通过 index.Add 函数添加这3个 Pod 资源对象。然后通过 index.ByIndex 函数查询在名为 namespace 的索引器下面匹配索引键为 default 的 Pod 列表。也就是查询 default 这个命名空间下面的所有 Pod,这里就是前两个定义的 Pod。
对上面的示例如果我们理解了,那么就很容易理解上面定义的4个数据结构了:
- IndexFunc:索引器函数,用于计算一个资源对象的索引值列表,上面示例是指定命名空间为索引值结果,当然我们也可以根据需求定义其他的,比如根据 Label 标签、Annotation 等属性来生成索引值列表。
- Index:存储数据,对于上面的示例,我们要查找某个命名空间下面的 Pod,那就要让 Pod 按照其命名空间进行索引,对应的 Index 类型就是
map[namespace]sets.pod。 - Indexers:存储索引器,key 为索引器名称,value 为索引器的实现函数,上面的示例就是
map["namespace"]MetaNamespaceIndexFunc。 - Indices:存储缓存器,key 为索引器名称,value 为缓存的数据,对于上面的示例就是
map["namespace"]map[namespace]sets.pod。
可能最容易混淆的是 Indexers 和 Indices 这两个概念,因为平时很多时候我们没有怎么区分二者的关系,这里我们可以这样理解:Indexers 是存储索引的,Indices 里面是存储的真正的数据(对象键),这样可能更好理解。

按照上面的理解我们可以得到上面示例的索引数据如下所示:
// Indexers 就是包含的所有索引器(分类)以及对应实现
Indexers: {
  "namespace": NamespaceIndexFunc,
  "nodeName": NodeNameIndexFunc,
}
// Indices 就是包含的所有索引分类中所有的索引数据
Indices: {
	"namespace": {  //namespace 这个索引分类下的所有索引数据
		"default": ["pod-1", "pod-2"],  // Index 就是一个索引键下所有的对象键列表
		"kube-system": ["pod-3"]   // Index
	},
	"nodeName": {  //nodeName 这个索引分类下的所有索引数据(对象键列表)
		"node1": ["pod-1"],  // Index
		"node2": ["pod-2", "pod-3"]  // Index
	}
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# 2.3.1 ThreadSafeMap
上面我们理解了 Indexer 中的几个重要的数据类型,下面我们来看下 Indexer 接口的具体实现 cache,位于文件 k8s.io/client-go/tools/cache/store.go 中:
// [k8s.io/client-go/tools/cache/store.go](<http://k8s.io/client-go/tools/cache/store.go>)

// cache 用一个 ThreadSafeStore 和一个关联的 KeyFunc 来实现 Indexer
type cache struct {
	// cacheStorage 是一个线程安全的存储
	cacheStorage ThreadSafeStore
  // keyFunc 用于计算对象键
	keyFunc KeyFunc
}
2
3
4
5
6
7
8
9
我们可以看到这个 cache 包含一个 ThreadSafeStore 的属性,这是一个并发安全的存储,因为是存储,所以自然就有存储相关的增、删、改、查等操作,Indexer 就是在 ThreadSafeMap 基础上进行封装的,实现了索引相关的功能。接下来我们先来看看 ThreadSafeStore 的定义,位于 k8s.io/client-go/tools/cache/thread_safe_store.go 文件中:
type ThreadSafeStore interface {
	Add(key string, obj interface{})
	Update(key string, obj interface{})
	Delete(key string)
	Get(key string) (item interface{}, exists bool)
	List() []interface{}
	ListKeys() []string
	Replace(map[string]interface{}, string)
	Index(indexName string, obj interface{}) ([]interface{}, error)
	IndexKeys(indexName, indexKey string) ([]string, error)
	ListIndexFuncValues(name string) []string
	ByIndex(indexName, indexKey string) ([]interface{}, error)
	GetIndexers() Indexers

	AddIndexers(newIndexers Indexers) error
	Resync() error
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
从接口的定义可以看出 ThreadSafeStore 和 Index 基本上差不多,但还是有一些区别的,这个接口是需要通过对象键来进行索引的。接下来我们来看看这个接口的具体实现 threadSafeMap 的定义:
// k8s.io/client-go/tools/cache/thread_safe_store.go

// threadSafeMap 实现了 ThreadSafeStore
type threadSafeMap struct {
	lock  sync.RWMutex
  // 存储资源对象数据,key(对象键) 通过 keyFunc 得到
  // 这就是真正存储的数据(对象键 -> 对象)
	items map[string]interface{}

	// indexers 索引分类与索引键函数的映射
	indexers Indexers
	// indices 通过索引可以快速找到对象键
	indices Indices
}
2
3
4
5
6
7
8
9
10
11
12
13
14
不要把索引键和对象键搞混了,索引键是用于对象快速查找的;对象键是对象在存储中的唯一命名,对象是通过名字+对象的方式存储的。接下来我们来仔细看下接口的具体实现,首先还是比较简单的 Add、Delete、Update 几个函数的实现:
// k8s.io/client-go/tools/cache/thread_safe_store.go

// 添加对象
func (c *threadSafeMap) Add(key string, obj interface{}) {
	c.lock.Lock()
	defer c.lock.Unlock()
  // 获取老的对象
	oldObject := c.items[key]
  // 写入新的对象,items 中存的是 objKey -> obj 的映射
	c.items[key] = obj
  // 添加了新的对象,所以要更新索引
	c.updateIndices(oldObject, obj, key)
}

// 更新对象,可以看到实现和 Add 是一样的
func (c *threadSafeMap) Update(key string, obj interface{}) {
	c.lock.Lock()
	defer c.lock.Unlock()
	oldObject := c.items[key]
	c.items[key] = obj
	c.updateIndices(oldObject, obj, key)
}

// 删除对象
func (c *threadSafeMap) Delete(key string) {
	c.lock.Lock()
	defer c.lock.Unlock()
  // 判断对象是否存在,存在才执行删除操作
	if obj, exists := c.items[key]; exists {
    // 删除对象索引
		c.deleteFromIndices(obj, key)
    // 删除对象本身
		delete(c.items, key)
	}
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
可以看到基本的实现比较简单,就是添加、更新、删除对象数据后,然后更新或删除对应的索引,所以我们需要查看下更新或删除索引的具体实现:
// k8s.io/client-go/tools/cache/thread_safe_store.go

// updateIndices 更新索引
func (c *threadSafeMap) updateIndices(oldObj interface{}, newObj interface{}, key string) {
	// 如果有旧的对象,需要先从索引中删除这个对象
	if oldObj != nil {
		c.deleteFromIndices(oldObj, key)
	}
  // 循环所有的索引器
	for name, indexFunc := range c.indexers {
    // 获取对象的索引键
		indexValues, err := indexFunc(newObj)
		if err != nil {
			panic(fmt.Errorf("unable to calculate an index entry for key %q on index %q: %v", key, name, err))
		}
    // 得到当前索引器的索引
		index := c.indices[name]
		if index == nil {
      // 没有对应的索引,则初始化一个索引
			index = Index{}
			c.indices[name] = index
		}
    // 循环所有的索引键
		for _, indexValue := range indexValues {
      // 得到索引键对应的对象键列表
			set := index[indexValue]
			if set == nil {
        // 没有对象键列表则初始化一个空列表
				set = sets.String{}
				index[indexValue] = set
			}
      // 将对象键插入到集合中,方便索引
			set.Insert(key)
		}
	}
}

// deleteFromIndices 删除对象索引
func (c *threadSafeMap) deleteFromIndices(obj interface{}, key string) {
  // 循环所有的索引器
	for name, indexFunc := range c.indexers {
    // 获取删除对象的索引键列表
		indexValues, err := indexFunc(obj)
		if err != nil {
			panic(fmt.Errorf("unable to calculate an index entry for key %q on index %q: %v", key, name, err))
		}
    // 获取当前索引器的索引
		index := c.indices[name]
		if index == nil {
			continue
		}
    // 循环所有索引键
		for _, indexValue := range indexValues {
      // 获取索引键对应的对象键列表
			set := index[indexValue]
			if set != nil {
        // 从对象键列表中删除当前要删除的对象键
				set.Delete(key)

				// 如果当集合为空的时候不删除set,那么具有高基数的短生命资源的 indices 会导致未使用的空集合随时间增加内存。
        // `kubernetes/kubernetes/issues/84959`.
        if len(set) == 0 {
					delete(index, indexValue)
				}
			}
		}
	}
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
添加索引和删除索引的实现都挺简单的,其实主要还是要对 indices、indexs 这些数据结构非常了解,这样就非常容易了,我们可以将 indexFunc 当成当前对象的命名空间来看待,这样对于上面的索引更新和删除的理解就肯定没问题了。
然后接下来就是几个查询相关的接口实现:
// k8s.io/client-go/tools/cache/thread_safe_store.go

// 获取对象
func (c *threadSafeMap) Get(key string) (item interface{}, exists bool) {
	c.lock.RLock()  // 只需要读锁
	defer c.lock.RUnlock()
  // 直接从 map 中读取值
	item, exists = c.items[key]
	return item, exists
}

// 对象列举
func (c *threadSafeMap) List() []interface{} {
	c.lock.RLock()
	defer c.lock.RUnlock()
	list := make([]interface{}, 0, len(c.items))
	for _, item := range c.items {
		list = append(list, item)
	}
	return list
}

// 返回 threadSafeMap 中所有的对象键列表
func (c *threadSafeMap) ListKeys() []string {
	c.lock.RLock()
	defer c.lock.RUnlock()
	list := make([]string, 0, len(c.items))
	for key := range c.items {
		list = append(list, key)
	}
	return list
}

// 替换所有对象,相当于重新构建索引
func (c *threadSafeMap) Replace(items map[string]interface{}, resourceVersion string) {
	c.lock.Lock()
	defer c.lock.Unlock()
  // 直接覆盖之前的对象
	c.items = items

	// 重新构建索引
	c.indices = Indices{}
	for key, item := range c.items {
    // 更新元素的索引
		c.updateIndices(nil, item, key)
	}
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
然后接下来就是和索引相关的几个接口实现,第一个就是 Index 函数:
// k8s.io/client-go/tools/cache/thread_safe_store.go

// 通过指定的索引器和对象获取符合这个对象特征的所有对象
func (c *threadSafeMap) Index(indexName string, obj interface{}) ([]interface{}, error) {
	c.lock.RLock()
	defer c.lock.RUnlock()
  // 获得索引器 indexName 的索引键计算函数
	indexFunc := c.indexers[indexName]
	if indexFunc == nil {
		return nil, fmt.Errorf("Index with name %s does not exist", indexName)
	}
  // 获取指定 obj 对象的索引键
	indexedValues, err := indexFunc(obj)
	if err != nil {
		return nil, err
	}
  // 获得索引器 indexName 的所有索引
	index := c.indices[indexName]

  // 用来存储对象键的集合
	var storeKeySet sets.String
	if len(indexedValues) == 1 {
    // 大多数情况下只有一个值匹配(默认获取的索引键就是对象的 namespace)
    // 直接拿到这个索引键的对象键集合
		storeKeySet = index[indexedValues[0]]
	} else {
    // 由于有多个索引键,则可能有重复的对象键出现,索引需要去重
		storeKeySet = sets.String{}
    // 循环索引键
		for _, indexedValue := range indexedValues {
      // 循环索引键下面的对象键,因为要去重
			for key := range index[indexedValue] {
				storeKeySet.Insert(key)
			}
		}
	}
  // 拿到了所有的对象键集合过后,循环拿到所有的对象集合
	list := make([]interface{}, 0, storeKeySet.Len())
	for storeKey := range storeKeySet {
		list = append(list, c.items[storeKey])
	}
	return list, nil
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
这个 Index 函数就是获取一个指定对象的索引键,然后把这个索引键下面的所有的对象全部获取到,比如我们要获取一个 Pod 所在命名空间下面的所有 Pod,如果更抽象一点,就是符合对象某些特征的所有对象,而这个特征就是我们指定的索引键函数计算出来的。然后接下来就是一个比较重要的 ByIndex 函数的实现:
// k8s.io/client-go/tools/cache/thread_safe_store.go

// 和上面的 Index 函数类似,只是是直接指定的索引键
func (c *threadSafeMap) ByIndex(indexName, indexedValue string) ([]interface{}, error) {
	c.lock.RLock()
	defer c.lock.RUnlock()

  // 获得索引器 indexName 的索引键计算函数
	indexFunc := c.indexers[indexName]
	if indexFunc == nil {
		return nil, fmt.Errorf("Index with name %s does not exist", indexName)
	}
  // 获得索引器 indexName 的所有索引
	index := c.indices[indexName]
  // 获取指定索引键的所有所有对象键
	set := index[indexedValue]
  // 然后根据对象键遍历获取对象
	list := make([]interface{}, 0, set.Len())
	for key := range set {
		list = append(list, c.items[key])
	}

	return list, nil
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
可以很清楚地看到 ByIndex 函数和 Index 函数比较类似,但是更简单了,直接获取一个指定的索引键的全部资源对象。然后是其他几个索引相关的函数:
// k8s.io/client-go/tools/cache/thread_safe_store.go

// IndexKeys 和上面的 ByIndex 几乎是一样的,只是这里是直接返回对象键列表
func (c *threadSafeMap) IndexKeys(indexName, indexedValue string) ([]string, error) {
	c.lock.RLock()
	defer c.lock.RUnlock()
  // 获取索引器 indexName 的索引键计算函数
	indexFunc := c.indexers[indexName]
	if indexFunc == nil {
		return nil, fmt.Errorf("Index with name %s does not exist", indexName)
	}
  // 获取索引器 indexName 的所有索引
	index := c.indices[indexName]
	// 直接获取指定索引键的对象键集合
	set := index[indexedValue]
	return set.List(), nil
}

// 获取索引器下面的所有索引键
func (c *threadSafeMap) ListIndexFuncValues(indexName string) []string {
	c.lock.RLock()
	defer c.lock.RUnlock()
  // 获取索引器 indexName 的所有索引
	index := c.indices[indexName]
	names := make([]string, 0, len(index))
  // 遍历索引得到索引键
	for key := range index {
		names = append(names, key)
	}
	return names
}

// 直接返回 indexers
func (c *threadSafeMap) GetIndexers() Indexers {
	return c.indexers
}

// 添加一个新的 Indexers
func (c *threadSafeMap) AddIndexers(newIndexers Indexers) error {
	c.lock.Lock()
	defer c.lock.Unlock()

	if len(c.items) > 0 {
		return fmt.Errorf("cannot add indexers to running index")
	}
  // 获取旧的索引器和新的索引器keys
	oldKeys := sets.StringKeySet(c.indexers)
	newKeys := sets.StringKeySet(newIndexers)

  // 如果包含新的索引器,则提示冲突
	if oldKeys.HasAny(newKeys.List()...) {
		return fmt.Errorf("indexer conflict: %v", oldKeys.Intersection(newKeys))
	}
  // 将新的索引器添加到 Indexers 中
	for k, v := range newIndexers {
		c.indexers[k] = v
	}
	return nil
}

// 没有真正实现 Resync 操作
func (c *threadSafeMap) Resync() error {
	return nil
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
这里我们就将 ThreadSafeMap 的实现进行了分析说明。整体来说比较方便,一个就是将对象数据存入到一个 map 中,然后就是维护索引,方便根据索引来查找到对应的对象。
# 2.3.2 cache
接下来再回过头去看 cache 的实现就非常简单了,因为 cache 就是对 ThreadSafeStore 的一个再次封装,很多操作都是直接调用的 ThreadSafeStore 的操作实现的,如下所示:
// k8s.io/client-go/tools/cache/store.go

// Add 插入一个元素到 cache 中
func (c *cache) Add(obj interface{}) error {
	key, err := c.keyFunc(obj)  // 生成对象键
	if err != nil {
		return KeyError{obj, err}
	}
  // 将对象添加到底层的 ThreadSafeStore 中
	c.cacheStorage.Add(key, obj)
	return nil
}

// 更新cache中的对象
func (c *cache) Update(obj interface{}) error {
	key, err := c.keyFunc(obj)
	if err != nil {
		return KeyError{obj, err}
	}
	c.cacheStorage.Update(key, obj)
	return nil
}

// 删除cache中的对象
func (c *cache) Delete(obj interface{}) error {
	key, err := c.keyFunc(obj)
	if err != nil {
		return KeyError{obj, err}
	}
	c.cacheStorage.Delete(key)
	return nil
}

// 得到cache中所有的对象
func (c *cache) List() []interface{} {
	return c.cacheStorage.List()
}

// 得到cache中所有的对象键
func (c *cache) ListKeys() []string {
	return c.cacheStorage.ListKeys()
}

// 得到cache中的Indexers
func (c *cache) GetIndexers() Indexers {
	return c.cacheStorage.GetIndexers()
}

// 得到对象obj与indexName索引器关联的所有对象
func (c *cache) Index(indexName string, obj interface{}) ([]interface{}, error) {
	return c.cacheStorage.Index(indexName, obj)
}

func (c *cache) IndexKeys(indexName, indexKey string) ([]string, error) {
	return c.cacheStorage.IndexKeys(indexName, indexKey)
}

func (c *cache) ListIndexFuncValues(indexName string) []string {
	return c.cacheStorage.ListIndexFuncValues(indexName)
}

func (c *cache) ByIndex(indexName, indexKey string) ([]interface{}, error) {
	return c.cacheStorage.ByIndex(indexName, indexKey)
}

func (c *cache) AddIndexers(newIndexers Indexers) error {
	return c.cacheStorage.AddIndexers(newIndexers)
}

func (c *cache) Get(obj interface{}) (item interface{}, exists bool, err error) {
	key, err := c.keyFunc(obj)
	if err != nil {
		return nil, false, KeyError{obj, err}
	}
	return c.GetByKey(key)
}

func (c *cache) GetByKey(key string) (item interface{}, exists bool, err error) {
	item, exists = c.cacheStorage.Get(key)
	return item, exists, nil
}

// 替换cache中所有的对象
func (c *cache) Replace(list []interface{}, resourceVersion string) error {
	items := make(map[string]interface{}, len(list))
	for _, item := range list {
		key, err := c.keyFunc(item)
		if err != nil {
			return KeyError{item, err}
		}
		items[key] = item
	}
	c.cacheStorage.Replace(items, resourceVersion)
	return nil
}

func (c *cache) Resync() error {
	return nil
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
可以看到 cache 没有自己独特的实现方式,都是调用的包含的 ThreadSafeStore 操作接口。
# 2.3.3 流程总结
前面我们已经知道了 Reflector 通过 ListAndWatch 把数据传入 DeltaFIFO 后,经过 DeltaFIFO 的 Pop 函数将资源对象存入到了本地的一个存储 Indexer 中,而这个底层真正的存储其实就是上面的 ThreadSafeStore。
要理解 Indexer 组件,最主要就是要把索引、索引器(索引分类)、索引键、对象键这几个概念弄清楚,有时候确实容易混乱,我们将上面的示例理解了应该就很好理解了,我们可以简单的理解为 Indexer 就是简单的把相同命名空间的对象放在一个集合中,然后基于命名空间来查找对象。
# 2.4 SharedInformer
若同一个资源的Informer被实例化了多次,每个Informer使用一个Reflector,那么会运行过多相同的ListAndWatch,太多重复的序列化和反序列化操作会导致api-server负载过重
SharedInformer可以使同一类资源Informer共享一个Reflector。内部定义了一个map字段,用于存放所有Infromer的字段。
# 2.4.1 SharedInformer
// k8s.io/client-go/tools/cache/shared_informer.go

type SharedInformer interface {
    // 添加资源事件处理器,当有资源变化时就会通过回调通知使用者
    AddEventHandler(handler ResourceEventHandler)
    // 需要周期同步的资源事件处理器
    AddEventHandlerWithResyncPeriod(handler ResourceEventHandler, resyncPeriod time.Duration)

    // 获取一个 Store 对象,前面我们讲解了很多实现 Store 的结构
    GetStore() Store
    // 获取一个 Controller,下面会详细介绍,主要是用来将 Reflector 和 DeltaFIFO 组合到一起工作
    GetController() Controller

    // SharedInformer 的核心实现,启动并运行这个 SharedInformer
    // 当 stopCh 关闭时候,informer 才会退出
    Run(stopCh <-chan struct{})

    // 告诉使用者全量的对象是否已经同步到了本地存储中
    HasSynced() bool
    // 最新同步资源的版本
    LastSyncResourceVersion() string
}

// 在 SharedInformer 基础上扩展了添加和获取 Indexers 的能力
type SharedIndexInformer interface {
    SharedInformer
    // 在启动之前添加 indexers 到 informer 中
    AddIndexers(indexers Indexers) error
    GetIndexer() Indexer
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
如果我们要处理资源的事件的话,就需要添加一个事件处理器,传入一个 ResourceEventHandler 接口,其定义如下所示:
// k8s.io/client-go/tools/cache/controller.go

type ResourceEventHandler interface {
    // 添加对象回调函数
    OnAdd(obj interface{})
    // 更新对象回调函数
    OnUpdate(oldObj, newObj interface{})
    // 删除对象回调函数
    OnDelete(obj interface{})
}
2
3
4
5
6
7
8
9
10
然后接下来我们来看看 SharedIndexInformer 的具体实现类的定义:
// k8s.io/client-go/tools/cache/shared_informer.go

type sharedIndexInformer struct {
    // Indexer也是一种Store,这个我们知道的,Controller负责把Reflector和FIFO逻辑串联起来
    // 所以这两个变量就涵盖了开篇那张图里面的Reflector、DeltaFIFO和LocalStore(cache)
    indexer    Indexer
    // 在 Controller 中将 Reflector 和 DeltaFIFO 关联了起来
    controller Controller

    // 可能会存在多个ResourceEventHandler 对 ResourceEventHandler 进行了一层层封装,统一由 sharedProcessor 管理
    processor             *sharedProcessor

    // 监控对象在一个时间窗口内是否发生了变化
    cacheMutationDetector MutationDetector

    // 用于 Reflector 中真正执行 ListAndWatch 的操作
    listerWatcher ListerWatcher

    // informer 中要处理的对象
    objectType    runtime.Object

    // 定期同步周期
    resyncCheckPeriod time.Duration
    // 任何通过 AddEventHandler 添加的处理程序的默认重新同步的周期
    defaultEventHandlerResyncPeriod time.Duration
    clock clock.Clock

    // 启动、停止标记
    started, stopped bool
    startedLock      sync.Mutex

    blockDeltas sync.Mutex
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
# 2.4.2 Controller
上面我们看到在 sharedIndexInformer 中定义了一个 Controller,这里的 Controller 并不是我们比较熟悉的 kube-controller-manager 管理的各种控制器,这里的 Controller 定义在 client-go/tools/cache/controller.go 中,目的是用来把 Reflector、DeltaFIFO 这些组件组合起来形成一个相对固定的、标准的处理流程。我们先来看下 Controller 的定义:
// k8s.io/client-go/tools/cache/controller.go

// Controller 的抽象接口
type Controller interface {
    // Run 函数主要做两件事,一件是构造并运行一个 Reflector 反射器,将对象/通知从 Config 的
    // ListerWatcher 送到 Config 的 Queue 队列,并在该队列上调用 Resync 操作
    // 另外一件事就是不断从队列中弹出对象,并使用 Config 的 ProcessFunc 进行处理
    Run(stopCh <-chan struct{})
    HasSynced() bool                 // APIServer 中的资源对象是否同步到了 Store 中
    LastSyncResourceVersion() string // 最新的资源版本号
}
2
3
4
5
6
7
8
9
10
11
因为 Controller 把多个模块整合起来实现了一套业务逻辑,所以在创建Controller 的时候需要提供一些配置:
// k8s.io/client-go/tools/cache/controller.go

type Config struct {
    Queue                          // 资源对象的队列,其实就是一个 DeltaFIFO
    ListerWatcher                  // 用来构造 Reflector 的
    Process ProcessFunc            // DeltaFIFO 队列 Pop 的时候回调函数,用于处理弹出的对象
    ObjectType runtime.Object      // 对象类型,也就是 Reflector 中使用的
    FullResyncPeriod time.Duration // 全量同步周期,在 Reflector 中使用
    ShouldResync ShouldResyncFunc  // Reflector 中是否需要 Resync 操作
    RetryOnError bool              // 出现错误是否需要重试
}
2
3
4
5
6
7
8
9
10
11
Controller 自己构造 Reflector 获取对象,Reflector 作为 DeltaFIFO 生产者持续监控 APIServer 的资源变化并推送到队列中。Controller 的 Run() 就是是队列的消费者,从队列中弹出对象并调用 Process() 进行处理。接下来我们来看 Controller 的一个具体实现 controller:
// k8s.io/client-go/tools/cache/controller.go

// controller是 Controller 的一个具体实现
type controller struct {
    config         Config       // 配置
    reflector      *Reflector   // 反射器
    reflectorMutex sync.RWMutex // 反射器的锁
    clock          clock.Clock  // 时钟
}

// 控制器核心实现
func (c *controller) Run(stopCh <-chan struct{}) {
    defer utilruntime.HandleCrash()
    // 新建一个协程,如果收到系统退出的信号就关闭队列
    go func() {
        <-stopCh
        c.config.Queue.Close()
    }()
    // 实例化一个 Reflector,传入的参数都是从 Config 中获取的
    r := NewReflector(
        c.config.ListerWatcher,
        c.config.ObjectType,
        c.config.Queue,
        c.config.FullResyncPeriod,
    )
    r.ShouldResync = c.config.ShouldResync
    r.clock = c.clock

    // 将反射器给到controller
    c.reflectorMutex.Lock()
    c.reflector = r
    c.reflectorMutex.Unlock()

    // 等待所有协程执行完毕
    var wg wait.Group
    defer wg.Wait()

    // StartWithChannel 会启动协程执行 Reflector.Run(),接收到 stopCh 信号才会退出协程
    wg.StartWithChannel(stopCh, r.Run)

		// wait.Unitl() 就是周期性的调用 c.processLoop() 操作处理弹出的对象
    wait.Until(c.processLoop, time.Second, stopCh)
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
从上面的核心函数 Run 的实现方式来看,该函数中主要就是实例化一个 Reflector,然后启动一个协程去执行这个反射器的 Run 函数,这个 Run 函数前面我们已经讲解过就是去调用 ListAndWatch 函数进行 List 和 Watch 操作,这个操作中具体的实现就是 Config 中的 ListerWatcher。然后的一个核心就是 processLoop() 函数的实现:
// k8s.io/client-go/tools/cache/controller.go

// 处理队列弹出的对象
func (c *controller) processLoop() {
  // 死循环,不断从队列中弹出对象来处理
	for {
    // 从队列中弹出一个对象,然后处理这个对象
    // 真正处理的是通过 Config 传递进来的 Process 函数
		obj, err := c.config.Queue.Pop(PopProcessFunc(c.config.Process))
		if err != nil {
      // 如果队列关闭了那就直接退出了
			if err == ErrFIFOClosed {
				return
			}
      // 如果配置的是错误后允许重试
			if c.config.RetryOnError {
				// 如果错误可以再重试那么将弹出的对象重新入队列进行处理
				c.config.Queue.AddIfNotPresent(obj)
			}
		}
	}
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
上面的代码其实核心的处理就是从 DeltaFIFO 中不断 Pop 出一个对象,然后交给 Config 传递进来的 Process 函数去处理,这个函数是在 SharedInformer 中初始化的时候传递进来的。
# 2.4.3 sharedProcessor
然后上面 SharedIndexInformer 的实现中还有一个比较重要的属性就是 sharedProcessor,就是专门来处理事件的,通过 AddEventHandler 函数添加的处理器就会被封装成 processorListener,然后通过 sharedProcessor 管理起来,其定义如下所示:
// k8s.io/client-go/tools/cache/shared_informer.go

// sharedProcessor 有一个 processorListener 的集合,可以向它的监听器分发事件通知对象。
type sharedProcessor struct {
	listenersStarted bool  // 所有处理器是否已经启动
	listenersLock    sync.RWMutex  // 读写锁🔒
	listeners        []*processorListener  // 通用的处理器列表
	syncingListeners []*processorListener  // 需要定时同步的处理器列表
	clock            clock.Clock
	wg               wait.Group
}

type processorListener struct {
	nextCh chan interface{}
	addCh  chan interface{}  // 添加事件的通道

	handler ResourceEventHandler

	// pendingNotifications 是一个无边界的环形缓冲区,用于保存所有尚未分发的通知。
	pendingNotifications buffer.RingGrowing

	requestedResyncPeriod time.Duration

	resyncPeriod time.Duration

	nextResync time.Time

	resyncLock sync.Mutex
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
processorListener 中就包含一个资源事件处理器,那么我们是如何传递事件进来的呢?首先我们来看看添加一个处理器是如何实现的:
// k8s.io/client-go/tools/cache/shared_informer.go

func (p *processorListener) add(notification interface{}) {
	p.addCh <- notification
}
2
3
4
5
可以看到添加事件很简单,直接通过 addCh 这个通道接收,notification 就是我们所说的事件,也就是前面我们常说的 DeltaFIFO 输出的 Deltas。上面我们可以看到 addCh 是定义成的一个无缓冲通道,所以这个 add() 函数就是一个事件分发器,从 DeltaFIFO 中弹出的对象要逐一送到多个处理器,如果处理器没有及时处理 addCh 则会阻塞住:
// k8s.io/client-go/tools/cache/shared_informer.go

func (p *processorListener) pop() {
	defer utilruntime.HandleCrash()
	defer close(p.nextCh) // 通知 run() 函数停止

	var nextCh chan<- interface{}
	var notification interface{}
  // 死循环
	for {
		select {
    // nextCh 还没初始化时,会被阻塞
		case nextCh <- notification:
			// 如果发送成功了(下面的 run 函数中消耗了数据后),从缓冲中再取一个事件出来
			var ok bool
			notification, ok = p.pendingNotifications.ReadOne()
			if !ok { // 没有事件被 Pop,设置 nextCh 为 nil
				nextCh = nil // Disable 这个 select 的 case
			}
    // 从 p.addCh 通道中读取一个事件,消费 addCh 通道
		case notificationToAdd, ok := <-p.addCh:
			if !ok {  // 如果关闭了,则退出
				return
			}
      // notification 为空说明还没发送任何事件给处理器(pendingNotifications 为空)
			if notification == nil {
        // 把刚刚获取的事件通过 p.nextCh 发送给处理器
				notification = notificationToAdd
				nextCh = p.nextCh
			} else {
        // 上一个事件还没发送完成(已经有一个通知等待发送),就先放到缓冲通道中
				p.pendingNotifications.WriteOne(notificationToAdd)
			}
		}
	}
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
pop() 函数的实现的利用了 golang 的 select 来同时操作多个 channel ,select 的 case 表达式都没有满足求值条件,那么 select 语句就会被阻塞,直到至少有一个 case 表达式满足条件为止,如果多个 case 语句同时满足则随机选择一个 case 执行。接下来,我们看看从 nextCh 读取事件后是如何处理的:
// k8s.io/client-go/tools/cache/shared_informer.go

func (p *processorListener) run() {
  // 当关闭 stopCh 后才会退出
	stopCh := make(chan struct{})
	wait.Until(func() {
    // 不断从 nextCh 通道中取数据
		for next := range p.nextCh {
      // 判断事件类型
			switch notification := next.(type) {
			case updateNotification:
				p.handler.OnUpdate(notification.oldObj, notification.newObj)
			case addNotification:
				p.handler.OnAdd(notification.newObj)
			case deleteNotification:
				p.handler.OnDelete(notification.oldObj)
			default:
				utilruntime.HandleError(fmt.Errorf("unrecognized notification: %T", next))
			}
		}
    // 当 p.nextCh 是空的且是关闭的时候才能到达这里,关闭 stopCh
		close(stopCh)
	}, 1*time.Second, stopCh)
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
run() 和 pop() 是 processorListener 的两个最核心的函数,processorListener 就是实现了事件的缓冲和处理,在没有事件的时候可以阻塞处理器,当事件较多是可以把事件缓冲起来,实现了事件分发器与处理器的异步处理。processorListener 的 run() 和 pop() 函数其实都是通过 sharedProcessor 启动的协程来调用的,所以下面我们再来对 sharedProcessor 进行分析了。首先看下如何添加一个 processorListener:
// k8s.io/client-go/tools/cache/shared_informer.go

// 添加处理器
func (p *sharedProcessor) addListener(listener *processorListener) {
	p.listenersLock.Lock()  // 加锁
	defer p.listenersLock.Unlock()
  // 调用 addListenerLocked 函数
	p.addListenerLocked(listener)
  // 如果事件处理列表中的处理器已经启动了,则手动启动下面的两个协程
  // 相当于启动后了
	if p.listenersStarted {
    // 通过 wait.Group 启动两个协程,就是上面我们提到的 run 和 pop 函数
		p.wg.Start(listener.run)
		p.wg.Start(listener.pop)
	}
}

// 将处理器添加到处理器的列表中
func (p *sharedProcessor) addListenerLocked(listener *processorListener) {
  // 添加到通用处理器列表中
	p.listeners = append(p.listeners, listener)
  // 添加到需要定时同步的处理器列表中
	p.syncingListeners = append(p.syncingListeners, listener)
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
这里添加处理器的函数 addListener 其实在 sharedIndexInformer 中的 AddEventHandler 函数中就会调用这个函数来添加处理器。然后就是事件分发的函数实现:
// k8s.io/client-go/tools/cache/shared_informer.go

func (p *sharedProcessor) distribute(obj interface{}, sync bool) {
	p.listenersLock.RLock()
	defer p.listenersLock.RUnlock()
  // sync 表示 obj 对象是否是同步事件对象
  // 将对象分发给每一个事件处理器列表中的处理器
	if sync {
		for _, listener := range p.syncingListeners {
			listener.add(obj)
		}
	} else {
		for _, listener := range p.listeners {
			listener.add(obj)
		}
	}
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
然后就是将 sharedProcessor 运行起来:
// k8s.io/client-go/tools/cache/shared_informer.go

func (p *sharedProcessor) run(stopCh <-chan struct{}) {
	func() {
		p.listenersLock.RLock()
		defer p.listenersLock.RUnlock()
    // 遍历所有的处理器,为处理器启动两个后台协程:run 和 pop 操作
    // 后续添加的处理器就是在上面的 addListener 中去启动的
		for _, listener := range p.listeners {
			p.wg.Start(listener.run)
			p.wg.Start(listener.pop)
		}
    // 标记为所有处理器都已启动
		p.listenersStarted = true
	}()
  // 等待退出信号
	<-stopCh
  // 接收到退出信号后,关闭所有的处理器
	p.listenersLock.RLock()
	defer p.listenersLock.RUnlock()
  // 遍历所有处理器
	for _, listener := range p.listeners {
    // 关闭 addCh,pop 会停止,pop 会通知 run 停止
		close(listener.addCh)
	}
  // 等待所有协程退出,就是上面所有处理器中启动的两个协程 pop 与 run
	p.wg.Wait()
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
到这里 sharedProcessor 就完成了对 ResourceEventHandler 的封装处理,当然最终 sharedProcessor 还是在 SharedInformer 中去调用的。
# 2.4.4 SharedInformer 的实现
接下来我们就来看下 SharedInformer 的具体实现:
// k8s.io/client-go/tools/cache/shared_informer.go

// 为 listwatcher 创建一个新的实例,用于 Reflector 从 apiserver 获取资源
// 所以需要外部提供一个资源类型
func NewSharedInformer(lw ListerWatcher, exampleObject runtime.Object, defaultEventHandlerResyncPeriod time.Duration) SharedInformer {
	// 调用 NewSharedIndexInformer 实现
  return NewSharedIndexInformer(lw, exampleObject, defaultEventHandlerResyncPeriod, Indexers{})
}

func NewSharedIndexInformer(lw ListerWatcher, exampleObject runtime.Object, defaultEventHandlerResyncPeriod time.Duration, indexers Indexers) SharedIndexInformer {
	realClock := &clock.RealClock{}
	sharedIndexInformer := &sharedIndexInformer{
	  processor:                       &sharedProcessor{clock: realClock},
    indexer:                         NewIndexer(DeletionHandlingMetaNamespaceKeyFunc, indexers),
		listerWatcher:                   lw,
		objectType:                      exampleObject,
		resyncCheckPeriod:               defaultEventHandlerResyncPeriod,
		defaultEventHandlerResyncPeriod: defaultEventHandlerResyncPeriod,
		cacheMutationDetector:           NewCacheMutationDetector(fmt.Sprintf("%T", exampleObject)),
		clock:                           realClock,
	}
	return sharedIndexInformer
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
实例化 SharedInformer 比较简单,实例化完成后就可以添加事件处理器了:
// k8s.io/client-go/tools/cache/shared_informer.go

// 使用默认的同步周期添加事件处理器
func (s *sharedIndexInformer) AddEventHandler(handler ResourceEventHandler) {
	s.AddEventHandlerWithResyncPeriod(handler, s.defaultEventHandlerResyncPeriod)
}

// 真正的添加事件处理器的实现
func (s *sharedIndexInformer) AddEventHandlerWithResyncPeriod(handler ResourceEventHandler, resyncPeriod time.Duration) {
	s.startedLock.Lock()
	defer s.startedLock.Unlock()
  // 如果已经结束了,那就直接返回了
	if s.stopped {
		klog.V(2).Infof("Handler %v was not added to shared informer because it has stopped already", handler)
		return
	}
  // 如果同步周期>0
	if resyncPeriod > 0 {
    // 同步周期不能小于最小的时间
		if resyncPeriod < minimumResyncPeriod {
			klog.Warningf("resyncPeriod %d is too small. Changing it to the minimum allowed value of %d", resyncPeriod, minimumResyncPeriod)
			resyncPeriod = minimumResyncPeriod
		}
    //
		if resyncPeriod < s.resyncCheckPeriod {
      // 如果已经启动了,那就用 resyncCheckPeriod 这个周期
			if s.started {
				klog.Warningf("resyncPeriod %d is smaller than resyncCheckPeriod %d and the informer has already started. Changing it to %d", resyncPeriod, s.resyncCheckPeriod, s.resyncCheckPeriod)
				resyncPeriod = s.resyncCheckPeriod
			} else {
        // 如果事件处理器的同步周期小于当前的 resyncCheckPeriod 且还没启动
        // 则更新 resyncCheckPeriod 为 resyncPeriod
        // 并相应调整所有监听器的同步周期
				s.resyncCheckPeriod = resyncPeriod
				s.processor.resyncCheckPeriodChanged(resyncPeriod)
			}
		}
	}

  // 新建事件处理器
	listener := newProcessListener(handler, resyncPeriod, determineResyncPeriod(resyncPeriod, s.resyncCheckPeriod), s.clock.Now(), initialBufferSize)

  // 如果没有启动,那么就直接添加处理器就可以了
	if !s.started {
    // 上面我们分析过添加事件处理器
		s.processor.addListener(listener)
		return
	}

	// blockDeltas 提供了一种方法来停止所有的事件分发,以便后面的事件处理器可以安全地加入 SharedInformer。
  s.blockDeltas.Lock()
	defer s.blockDeltas.Unlock()
  // 添加处理器
	s.processor.addListener(listener)

  // 因为到这里证明 SharedInformer 已经启动了,可能很多对象已经让其他处理器处理过了
  // 所以这些对象就不会再通知新添加的处理器了,所以这里遍历 indexer 中的所有对象去通知新添加的处理器
	for _, item := range s.indexer.List() {
		listener.add(addNotification{newObj: item})
	}
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
事件处理器添加完过后就要看下 SharedInformer 是如何把事件分发给每个处理器的了:
// k8s.io/client-go/tools/cache/shared_informer.go

func (s *sharedIndexInformer) Run(stopCh <-chan struct{}) {
	defer utilruntime.HandleCrash()
  // 新建一个 DeltaFIFO
	fifo := NewDeltaFIFOWithOptions(DeltaFIFOOptions{
		KnownObjects:          s.indexer,
		EmitDeltaTypeReplaced: true,
	})
  // 用于构造 Controller 的配置
	cfg := &Config{
		Queue:            fifo,
		ListerWatcher:    s.listerWatcher,
		ObjectType:       s.objectType,
		FullResyncPeriod: s.resyncCheckPeriod,
		RetryOnError:     false,
		ShouldResync:     s.processor.shouldResync,
    // Controller 调用 DeltaFIFO 的 Pop 函数传入这个回调函数来处理弹出的对象
		Process: s.HandleDeltas,
	}

	func() {
		s.startedLock.Lock()
		defer s.startedLock.Unlock()
    // 新建一个 Controller 并标记为已经启动
		s.controller = New(cfg)
		s.controller.(*controller).clock = s.clock
		s.started = true
	}()

	processorStopCh := make(chan struct{})
	var wg wait.Group
	defer wg.Wait()              // 等待处理器停止
	defer close(processorStopCh) // 通知处理器停止
  // 启动两个协程
	wg.StartWithChannel(processorStopCh, s.cacheMutationDetector.Run)
	wg.StartWithChannel(processorStopCh, s.processor.run)

	defer func() {
		s.startedLock.Lock()
		defer s.startedLock.Unlock()
    // 标记为已停止
		s.stopped = true
	}()
  // 启动 Controller
	s.controller.Run(stopCh)
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
sharedIndexInformer 通过 Run() 函数启动了 Controller 和 sharedProcess,Controller 通过 DeltaFIFO 的 Pop 函数弹出 Deltas 对象,并使用 HandleDeltas 函数来处理这个对象,前面其实我们就讲解过。这个函数把 Deltas 转换为 sharedProcess 需要的各种Notification 类型。
// k8s.io/client-go/tools/cache/shared_informer.go

// DeltaFIFO 的对象被 Pop 后的处理函数
func (s *sharedIndexInformer) HandleDeltas(obj interface{}) error {
	s.blockDeltas.Lock()
	defer s.blockDeltas.Unlock()

	// 因为 Deltas 是 Delta 列表,里面包含一个对象的多个操作
  // 所以要从最老的 Delta 到最新的 Delta 遍历处理
	for _, d := range obj.(Deltas) {
		switch d.Type { // 根据对象操作类型进行处理
    // 同步、替换、添加、更新类型
		case Sync, Replaced, Added, Updated:
			s.cacheMutationDetector.AddObject(d.Object)
      // 如果 indexer 中有这个对象,则当成更新事件进行处理
			if old, exists, err := s.indexer.Get(d.Object); err == nil && exists {
				if err := s.indexer.Update(d.Object); err != nil {
					return err
				}

				isSync := false
				switch {
				case d.Type == Sync:
					isSync = true
				case d.Type == Replaced:
					if accessor, err := meta.Accessor(d.Object); err == nil {
						if oldAccessor, err := meta.Accessor(old); err == nil {
							isSync = accessor.GetResourceVersion() == oldAccessor.GetResourceVersion()
						}
					}
				}
        // 通知处理器处理事件
				s.processor.distribute(updateNotification{oldObj: old, newObj: d.Object}, isSync)
			} else {
        // 将对象添加到 indexer 存储中
				if err := s.indexer.Add(d.Object); err != nil {
					return err
				}
        // 然后通知处理器处理事件
				s.processor.distribute(addNotification{newObj: d.Object}, false)
			}
    // 删除类型
		case Deleted:
      // 从 indexer 中删除对象
			if err := s.indexer.Delete(d.Object); err != nil {
				return err
			}
      // 通知所有的处理器对象被删除了
			s.processor.distribute(deleteNotification{oldObj: d.Object}, false)
		}
	}
	return nil
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
# 2.4.5 SharedInformerFactory
type SharedInformerFactory interface {
	Start(stopCh <-chan struct{})
	InformerFor(obj runtime.Object, newFunc NewInformerFunc) cache.SharedIndexInformer
}
2
3
4
type SharedInformerFactory interface {
	internalinterfaces.SharedInformerFactory
	ForResource(resource schema.GroupVersionResource) (GenericInformer, error)
	WaitForCacheSync(stopCh <-chan struct{}) map[reflect.Type]bool

	Admissionregistration() admissionregistration.Interface
	Internal() apiserverinternal.Interface
	Apps() apps.Interface
	Autoscaling() autoscaling.Interface
	Batch() batch.Interface
	Certificates() certificates.Interface
	Coordination() coordination.Interface
	Core() core.Interface
	Discovery() discovery.Interface
	Events() events.Interface
	Extensions() extensions.Interface
	Flowcontrol() flowcontrol.Interface
	Networking() networking.Interface
	Node() node.Interface
	Policy() policy.Interface
	Rbac() rbac.Interface
	Scheduling() scheduling.Interface
	Storage() storage.Interface
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
具体实现 sharedInformerFactory
// staging/client-go/informer/factory.go
type sharedInformerFactory struct {
  client           kubernetes.Interface
  namespace        string
  tweakListOptions internalinterfaces.TweakListOptionsFunc
  lock             sync.Mutex
  defaultResync    time.Duration
  customResync     map[reflect.Type]time.Duration

  // 按照类型存放共享的informer
  informers map[reflect.Type]cache.SharedIndexInformer

  // 这个字段用来追踪informers是否被启动了
  // 可以保证Start()方法安全的重复调用多次(幂等性)
  startedInformers map[reflect.Type]bool
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
启动 Start方法
func (f *sharedInformerFactory) Start(stopCh <-chan struct{}) {
  ...
  // 遍历所有的informers
  for informerType, informer := range f.informers {
    if !f.startedInformers[informerType] {
      // 每一种informer启动一个协程,运行Run方法
      go informer.Run(stopCh)
      f.startedInformers[informerType] = true
    }
  }
}
2
3
4
5
6
7
8
9
10
11
注册 InformerFor方法
func (f *sharedInformerFactory) InformerFor(obj runtime.Object, newFunc internalinterfaces.NewInformerFunc) cache.SharedIndexInformer {
	f.lock.Lock()
	defer f.lock.Unlock()

	informerType := reflect.TypeOf(obj)
	informer, exists := f.informers[informerType]
	if exists {
		return informer
	}

	resyncPeriod, exists := f.customResync[informerType]
	if !exists {
		resyncPeriod = f.defaultResync
	}

	informer = newFunc(f.client, resyncPeriod)
	f.informers[informerType] = informer

	return informer
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
# 2.4.6 流程总结
- 通过 Reflector 实现资源对象的 List 和 Watch 操作
- 将通过 List 全量列举的对象存储在 Indexer 中,然后再 Watch 资源,一旦有变化就更新 Indexer,并在 Indexer 中采用 Namespace 做对象索引
- 更新到 Indexer 的过程通过 DeltaFIFO 实现有顺序的更新,因为资源状态是通过全量+增量的方式实现同步的,所以顺序错误会造成状态不一致
- 使用者可以注册回调函数,在更新到 Indexer 的同时通知使用者去处理,为了保证回调处理不被某一个处理器阻塞,SharedInformer 实现了processorListener 异步缓冲处理
- 整个过程是通过 Controller 来驱动的
# 2.5 Workqueue
未完待续...