# mysql 中索引语法以及分类
# 1. 索引概述
索引是帮助 MySQL 高效获取数据的数据结构(有序)。
在数据之外,数据库系统还维护着满足特定查找算法的数据结构,这些数据结构以某种方式引用(指向)数据,这样就可以在这些数据结构上实现高级查询算法,这种数据结构就是索引。

---------------------------------
|   索引是一种数据结构
|   索引要短
|   索引不是越多越好
|   索引可以提高查询效率
---------------------------------
优点:
    提高数据检索效率,降低数据库的IO成本
    通过索引列对数据进行排序,降低数据排序的成本,降低CPU的消耗

缺点:
    索引列也是要占用空间的
    索引大大提高了查询效率,但降低了更新的速度,比如 INSERT、UPDATE、DELETE
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# 2. 索引分类
| 分类 | 含义 | 特点 | 关键字 |
|---|---|---|---|
| 主键索引 | 针对于表中主键创建的索引 | 默认自动创建,只能有一个 | PRIMARY |
| 唯一索引 | 避免同一个表中某数据列中的值重复 | 可以有多个 | UNIQUE |
| 常规索引 | 快速定位特定数据 | 可以有多个 | - |
| 全文索引 | 全文索引查找的是文本中的关键词,而不是比较索引中的值 | 可以有多个 | FULLTEXT |
- 在 InnoDB 存储引擎中,根据索引的存储形式,又可以分为以下两种:
| 分类 | 含义 | 特点 |
|---|---|---|
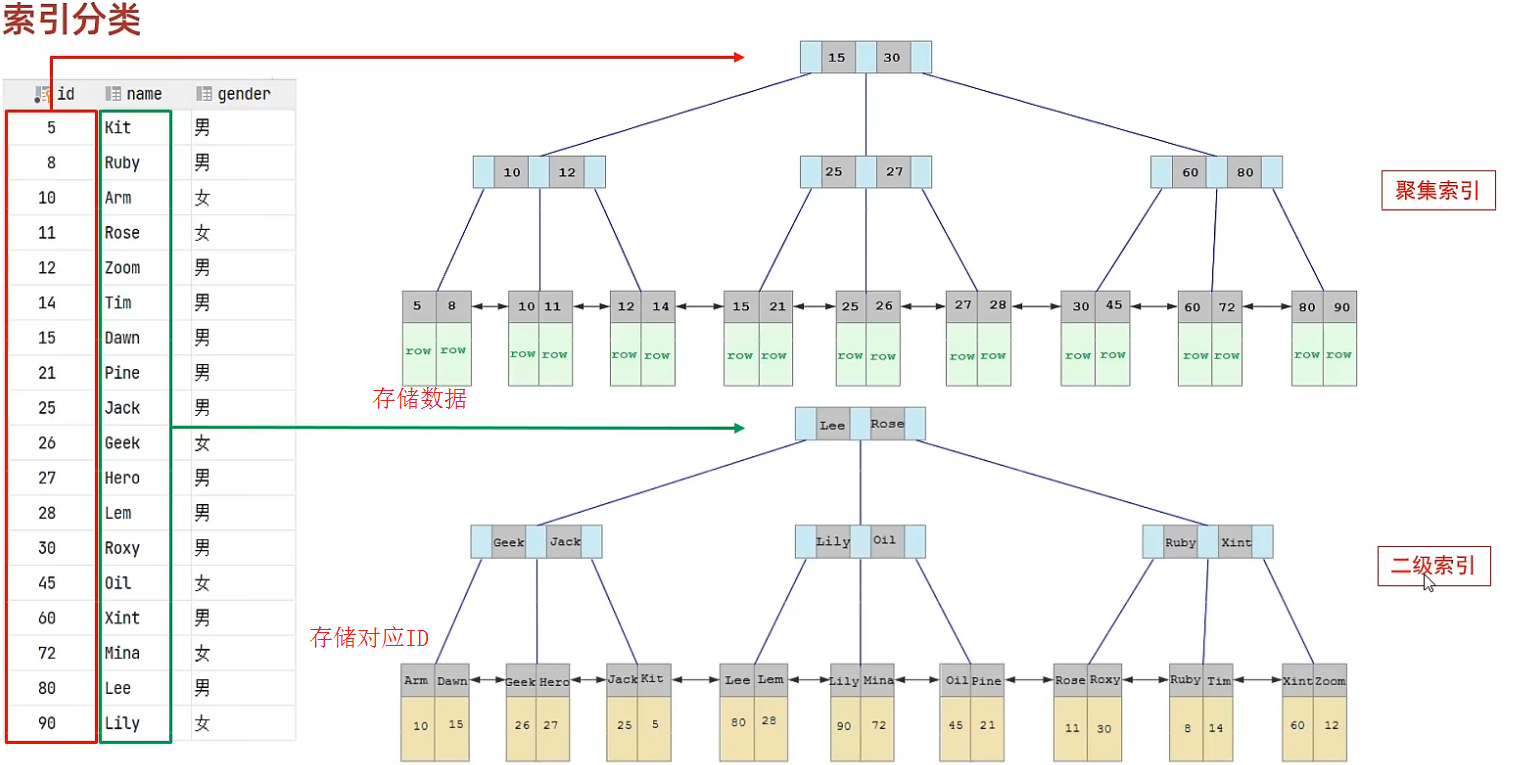
| 聚集索引(Clustered Index) | 将数据存储与索引放一块,索引结构的叶子节点保存了行数据 | 必须有,而且只有一个 |
| 二级索引(Secondary Index) | 将数据与索引分开存储,索引结构的叶子节点关联的是对应的主键 | - |
- 聚集索引 / 二级索引(非聚集索引)
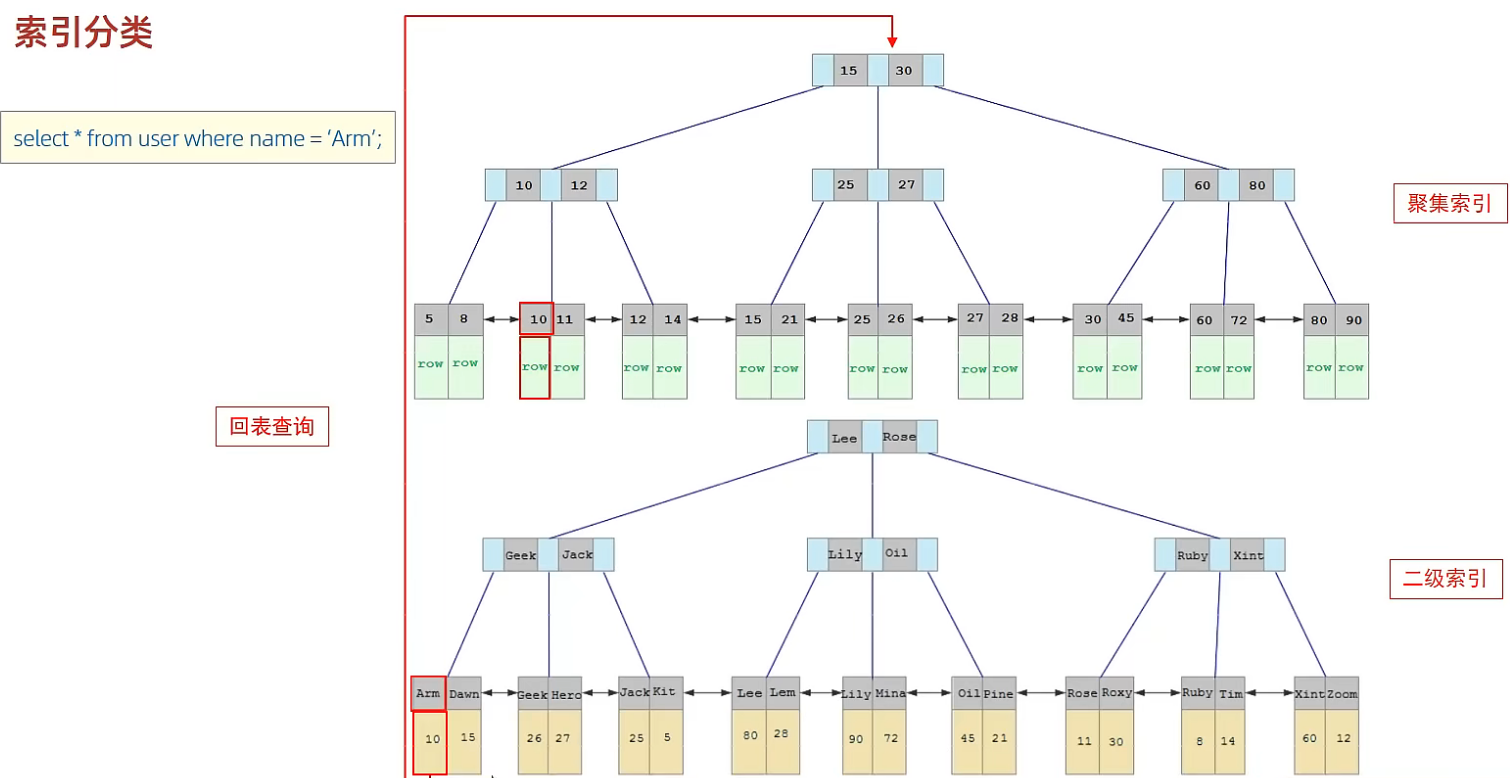
-- 1) 根据name的索引查出聚集索引id
-- 2) 之后需要回表根据id查出所需要的内容
select * from $table_name where name="arm";
1
2
3
2
3
- 聚集索引选取规则:
1) 如果存在主键,主键索引就是聚集索引
2) 如果不存在主键,将使用第一个唯一(UNIQUE)索引作为聚集索引
3) 如果表没有主键或没有合适的唯一索引,则 InnoDB 会自动生成一个 rowid 作为隐藏的聚集索引
1
2
3
2
3
# 3. 索引语法
-- 1) 创建索引
CREATE [ UNIQUE | FULLTEXT ] INDEX $index_name ON $table_name ($index_col_name, ...);

-- 2) 查看索引
SHOW INDEX FROM $table_name;

-- 3) 删除索引
DROP INDEX $index_name ON $table_name;

-- 4) case

-- name字段为姓名字段,该字段的值可能会重复,为该字段创建索引
create index idx_user_name on tb_user(name);

-- phone手机号字段的值非空,且唯一,为该字段创建唯一索引
create unique index idx_user_phone on tb_user (phone);

-- 为profession, age, status创建联合索引
create index idx_user_pro_age_stat on tb_user(profession, age, status);

-- 为email建立合适的索引来提升查询效率
create index idx_user_email on tb_user(email);

-- 删除索引
drop index idx_user_email on tb_user;
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
# 4. 索引设计原则
1) 对于数据量较大,且查询比较频繁的表建立索引

2) 针对于常作为查询条件(where)、排序(order by)、分组(group by)操作的字段建立索引

3) 尽量选择区分度高的列作为索引,尽量建立唯一索引,区分度越高,使用索引的效率越高

4) 如果是字符串类型的字段,字段长度较长,可以针对于字段的特点,建立前缀索引

5) 尽量使用联合索引,减少单列索引,查询时,联合索引很多时候可以覆盖索引,节省存储空间,避免回表,提高查询效率

6) 要控制索引的数量,索引并不是多多益善,索引越多,维护索引结构的代价就越大,会影响增删改的效率

7) 如果索引列不能存储NULL值,请在创建表时使用NOT NULL约束它。当优化器知道每列是否包含NULL值时,它可以更好地确定哪个索引最有效地用于查询
1
2
3
4
5
6
7
8
9
10
11
12
13
2
3
4
5
6
7
8
9
10
11
12
13
← 1. 存储引擎 mysql 中的索引结构 →