# Redis 的「内存淘汰策略」和「过期删除策略」
# 1. 过期删除策略
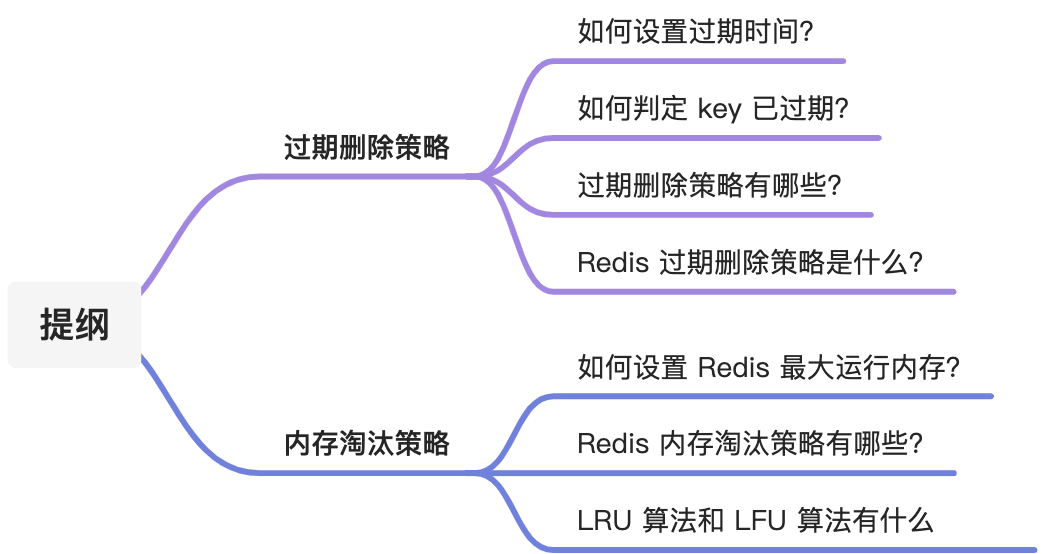
Redis 是可以对 key 设置过期时间的,因此需要有相应的机制将已过期的键值对删除,而做这个工作的就是过期键值删除策略。
expire <key> <n>:设置 key 在 n 秒后过期
pexpire <key> <n>:设置 key 在 n 毫秒后过期
expireat <key> <n>:设置 key 在某个时间戳(精确到秒)之后过期
pexpireat <key> <n>:设置 key 在某个时间戳(精确到毫秒)之后过期
2
3
4
设置字符串时,也可以同时对 key 设置过期时间,共有 3 种命令:
set <key> <value> ex <n> :设置键值对的时候,同时指定过期时间(精确到秒)
set <key> <value> px <n> :设置键值对的时候,同时指定过期时间(精确到毫秒)
setex <key> <n> <valule> :设置键值对的时候,同时指定过期时间(精确到秒)
常见的三种过期删除策略
# 1.1 定时删除
- 定时删除策略是怎么样的?
定时删除策略的做法是,在设置 key 的过期时间时,同时创建一个定时事件,当时间到达时,由事件处理器自动执行 key 的删除操作。
- 定时删除的优缺点是?
定时删除策略的优点:
	可以保证过期 key 会被尽快删除,也就是内存可以被尽快地释放。因此,定时删除对内存是最友好的。

定时删除策略的缺点:
	在过期 key 比较多的情况下,删除过期 key 可能会占用相当一部分 CPU 时间,在内存不紧张但 CPU 时间紧张的情况下,将 CPU 时间用于删除和当前任务无关的过期键上,无疑会对服务器的响应时间和吞吐量造成影响。所以,定时删除策略对 CPU 不友好。
2
3
4
5
# 1.2 惰性删除
- 惰性删除策略是怎么样的?
惰性删除策略的做法是,不主动删除过期键,每次从数据库访问 key 时,都检测 key 是否过期,如果过期则删除该 key。
- 惰性删除的优缺点是?
惰性删除策略的优点:
	因为每次访问时,才会检查 key 是否过期,所以此策略只会使用很少的系统资源,因此,惰性删除策略对 CPU 时间最友好。

惰性删除策略的缺点:
	如果一个 key 已经过期,而这个 key 又仍然保留在数据库中,那么只要这个过期 key 一直没有被访问,它所占用的内存就不会释放,造成了一定的内存空间浪费。所以,惰性删除策略对内存不友好。
2
3
4
5
# 1.3 定期删除
- 定期删除策略是怎么样的?
定期删除策略的做法是,每隔一段时间「随机」从数据库中取出一定数量的 key 进行检查,并删除其中的过期key。
- 定期删除的优缺点是?
定期删除策略的优点:
	通过限制删除操作执行的时长和频率,来减少删除操作对 CPU 的影响,同时也能删除一部分过期的数据减少了过期键对空间的无效占用。

定期删除策略的缺点:
	内存清理方面没有定时删除效果好,同时没有惰性删除使用的系统资源少。
	难以确定删除操作执行的时长和频率。如果执行的太频繁,定期删除策略变得和定时删除策略一样,对CPU不友好;如果执行的太少,那又和惰性删除一样了,过期 key 占用的内存不会及时得到释放。
2
3
4
5
6
# 2. 内存淘汰策略
当 Redis 的运行内存已经超过 Redis 设置的最大内存之后,则会使用内存淘汰策略删除符合条件的 key,以此来保障 Redis 高效的运行
# 2.1 Redis 内存淘汰策略有哪些?
Redis 内存淘汰策略共有八种,这八种策略大体分为「不进行数据淘汰」和「进行数据淘汰」两类策略
不进行数据淘汰的策略: noeviction(Redis3.0之后,默认的内存淘汰策略) :它表示当运行内存超过最大设置内存时,不淘汰任何数据,而是不再提供服务,直接返回错误
# 2.2.进行数据淘汰的策略
- 在设置了过期时间的数据中进行淘汰
volatile-random:随机淘汰设置了过期时间的任意键值;
volatile-ttl:优先淘汰更早过期的键值。
volatile-lru(Redis3.0 之前,默认的内存淘汰策略):淘汰所有设置了过期时间的键值中,最久未使用的键值;
volatile-lfu(Redis 4.0 后新增的内存淘汰策略):淘汰所有设置了过期时间的键值中,最少使用的键值;
2
3
4
- 在所有数据范围内进行淘汰
allkeys-random:随机淘汰任意键值;
allkeys-lru:淘汰整个键值中最久未使用的键值;
allkeys-lfu(Redis 4.0 后新增的内存淘汰策略):淘汰整个键值中最少使用的键值
2
3
# 2.3 LRU & LFU
- LRU 算法?
LRU 全称是 Least Recently Used 翻译为最近最少使用,会选择淘汰最近最少使用的数据。
传统 LRU 算法的实现是基于「链表」结构,链表中的元素按照操作顺序从前往后排列,最新操作的键会被移动到表头,当需要内存淘汰时,只需要删除链表尾部的元素即可,因为链表尾部的元素就代表最久未被使用的元素。
- LFU 算法?
LFU 全称是 Least Frequently Used 翻译为最近最不常用的,LFU 算法是根据数据访问次数来淘汰数据的,它的核心思想是“如果数据过去被访问多次,那么将来被访问的频率也更高”。
LFU 算法会记录每个数据的访问次数。当一个数据被再次访问时,就会增加该数据的访问次数。这样就解决了偶尔被访问一次之后,数据留存在缓存中很长一段时间的问题,相比于 LRU 算法也更合理一些。